

Gemini 3.8 Live er Googles nye stemmemodel. Den lytter og svarer i lyd i én og samme model, og den kan slå op i jeres systemer, mens den taler. Google lancerede den 15. september 2026 sammen med søstermodellen Gemini 3.8 Live Extended Think…
Gemini 3.8 Live er Googles nye stemmemodel. Den lytter og svarer i lyd i én og samme model, og den kan slå op i jeres systemer, mens den taler. Google lancerede den 15. september 2026 sammen med søstermodellen Gemini 3.8 Live Extended Thinking, der nu ligger nummer 1 på Artificial Analysis' uafhængige rangliste for tale-til-tale-modeller.
Samme analysevirksomheds blindtest viser dog, at brugerne foretrækker at tale med standardmodellen, som også er hurtigere og i praksis billigere. Her gennemgår vi, hvad de 2 modeller kan, hvad de koster, hvorfor ingen af dem er klar til bankforløb endnu, og hvilke regler du selv skal sørge for.
Hvad Google lancerede
Google DeepMind udgav 2 modeller med model-id'erne gemini-3.8-live og gemini-3.8-live-extended-thinking. Begge er native speech-to-speech-modeller, altså modeller, der lytter til lyd og svarer med lyd uden at gå omvejen over tekst. De afløser Gemini 3.1 Flash Live i Gemini-familien. Googles lanceringsindlæg er skrevet af Tom Ouyang og Malini Jaganathan fra Googles lydteam, og en separat udviklerblog fulgte samme dag.
Den klassiske stemmeløsning er en kæde af 3 systemer: talegenkendelse, der laver lyd om til tekst, en sprogmodel, der finder svaret, og talesyntese, der læser svaret op. Hvert led lægger ventetid til, og tonefald og afbrydelser går tabt undervejs. Med en native model forsvinder de overgange. Det er grundprincippet bag realtids-stemme-AI.
Standardmodellen er bygget til hurtig, naturlig samtale. Extended Thinking-varianten ræsonnerer i baggrunden, mens den taler, og siger ting som "lad mig tjekke det", mens den arbejder. Du kan sætte dens tænkeniveau til low, medium eller high.
Modellerne er tilgængelige i Gemini API og Google AI Studio. For forbrugere kører standardmodellen i Search Live, mens Extended Thinking kører i Gemini Live-appen, i Docs for Google AI Pro og Ultra og i Gmail og Keep for alle Google AI-abonnenter. I Gemini Enterprise er begge modeller i privat preview.
Hvad modellerne kan, og hvad de ikke kan
Begge modeller tager tekst, billeder, lyd og video ind og sender tekst og lyd ud. Kontekstvinduet er 131.072 tokens ind og 65.536 tokens ud. Live API understøtter 97 sprog, og dansk er på listen. Modellen opdager selv, når kunden skifter sprog midt i samtalen.
Den tekniske nyhed med størst betydning for virksomheder er asynkrone værktøjskald. Agenten kan kalde et API, for eksempel et ordreopslag i jeres ERP-system, og tale videre med kunden, mens svaret er undervejs. Det er tool calling uden den pinlige tavshed. Extended Thinking kræver, at alle værktøjer er sat op som ikke-blokerende, og din integration skal holde øje med et nyt statusfelt, der fortæller, om modellen stadig arbejder, før den lægger på eller stiller om.
Listen over det, modellerne ikke kan, er lige så vigtig. Google skriver i modelkortene, at caching, code execution, file search, structured outputs, URL context og Batch API ikke understøttes. Function calling og søgning via Google Search virker. Mangler structured outputs, skal du selv validere de data, agenten skriver tilbage i jeres systemer.
Der er også praktiske grænser. Live API begrænser som udgangspunkt en session til 15 minutter med ren lyd og 2 minutter med video. Modelkortet nævner risiko for hallucinationer og lejlighedsvise problemer med latens og timeouts, og modellernes viden stopper i januar 2025. Al lyd får et usynligt SynthID-vandmærke, som vi har skrevet mere om i SynthID-artiklen.
De uafhængige tal: 2 modeller til 2 opgaver
Google bruger tal fra Artificial Analysis i sin lancering, men målingerne er analysevirksomhedens egne. Artificial Analysis har kørt modellerne gennem Live API, og deres Speech to Speech-rangliste vægter 3 test lige: ræsonnement (Big Bench Audio), turtagning og afbrydelser (Full Duplex Bench) og løste kundeservicesager (τ-Voice). Tallene her er aflæst den 16. september 2026.
Extended Thinking (High) ligger nummer 1 med 82,6 foran OpenAIs GPT-Live-1 med Astra-backend på 81,5 og xAIs Grok Voice Think Fast 2.0 på 81,3. Standardmodellen ligger nummer 5 med 76,0. Forgængeren Gemini 3.1 Flash Live (High) ligger på 71,5. Forspringet til nummer 2 er 1,1 point, så de 3 øverste ligger tæt.
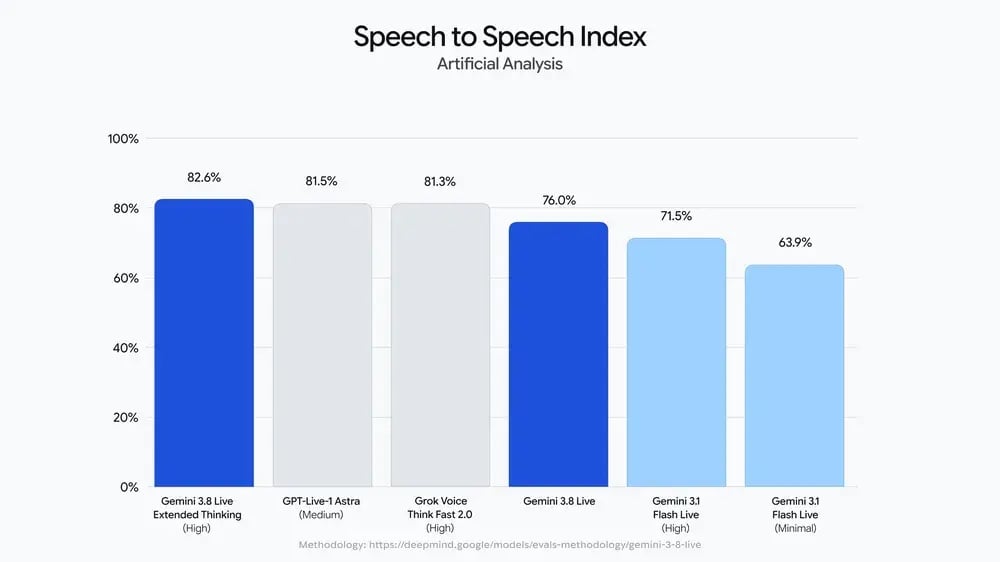
Speech to Speech Index fra Artificial Analysis. Grafik: Google, evalueringsnotat for Gemini 3.8 Live.
Den store forskel mellem de 2 Gemini-modeller ses i τ-Voice, hvor agenten skal løse hele kundeservicesager. Her løser Extended Thinking 68,6 procent, mens standardmodellen løser 30,1 procent. Til gengæld er standardmodellen hurtigere: 1,18 sekunder til første lyd mod 1,35 sekunder for Extended Thinking. Gemini 3.1 Flash Live (High) brugte 2,99 sekunder.
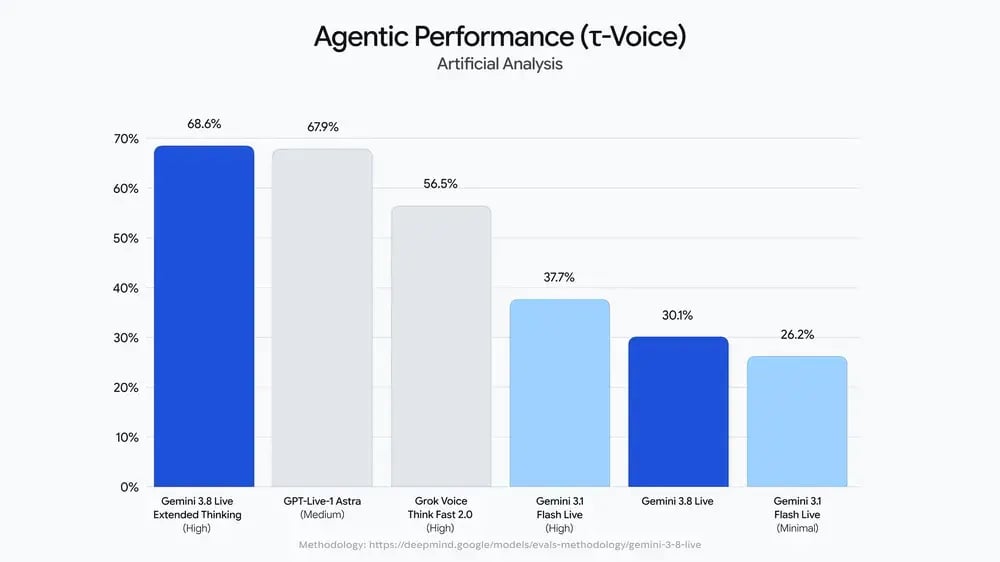
Løste kundeservicesager i τ-Voice. Grafik: Google, evalueringsnotat for Gemini 3.8 Live.
I Artificial Analysis' Speech Agent Arena stemmer rigtige mennesker blindt på den samtale, de bedst kan lide. Her får standardmodellen en Elo-score på 1083, mens Extended Thinking kun får 990. Standardmodellen løser endda flere af arenaens simple opgaver, som at booke en tandlægetid, med 93,2 procent mod 89,1 procent. Google skriver, at 3.8 Live er nummer 2 i arenaen. Det passer, men nummer 1 er Googles egen forgænger, Gemini 3.1 Flash Live i Minimal-varianten, med 1096.
Samtalekvaliteten ligger med andre ord i standardmodellen, og evnen til at løse sager med flere skridt ligger i Extended Thinking. Ifølge Googles evalueringsnotat er målingerne kørt på model-id'et gemini-3.8-live-preview for standardmodellen.
Prisen: listeprisen er ikke det, du betaler
Ifølge Googles prisside har de 2 modeller samme listepris. Lyd ind koster 3 dollar pr. million tokens, som Google omregner til cirka 0,005 dollar pr. minut. Lyd ud koster 12 dollar pr. million tokens eller cirka 0,018 dollar pr. minut. Tekst koster 0,75 dollar ind og 4,50 dollar ud pr. million tokens.
Lægger du minutpriserne sammen for en time, hvor der konstant går lyd begge veje, giver det 1,38 dollar. Artificial Analysis har målt noget andet, nemlig udgiften pr. time inputlyd på deres testsæt: 0,84 dollar for standardmodellen og 3,50 dollar for Extended Thinking (High). Med samme listepris koster Extended Thinking omkring 4 gange så meget i målingen.
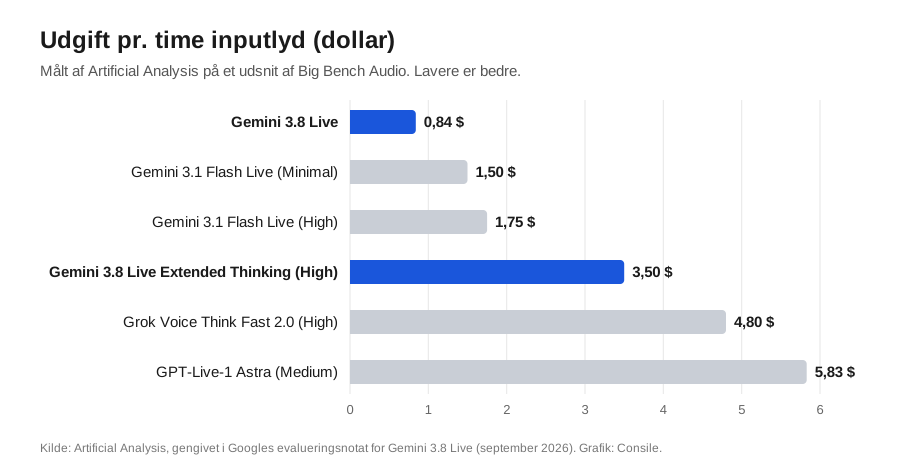
Udgift pr. time inputlyd målt af Artificial Analysis. Tal fra Googles evalueringsnotat, grafik: Consile.
Fodnoten på Googles udviklerblog siger kun, at minutpriserne er et estimat regnet ud fra tokenpriserne. Der står ikke noget om en tidsbegrænset introduktionspris, så den skal du ikke regne med eller imod.
For en business case betyder det 2 ting. Regn på jeres egne testopkald, ikke på minutprisen. Og lad kun de sager gå til Extended Thinking, der faktisk kræver det.
Konkurrenterne: GPT-Live-1 og Grok Voice
OpenAI lancerede GPT-Live-1 i API'et den 10. september 2026. Modellen lytter og taler samtidig og sender ræsonnement og værktøjer videre til en valgfri backend-model som GPT-6 Astra. Du betaler 0,05 dollar pr. minut for stemmelaget og betaler for backend-modellen oven i. Artificial Analysis måler udgiften til 5,83 dollar pr. time inputlyd med Astra, og den løser 67,9 procent på τ-Voice. Luna og Terra kan også bruges som backend, og dem gennemgik vi i artiklen om OpenAIs prisfald på Luna og Terra.
xAIs Grok Voice Think Fast 2.0 svarer hurtigst af topmodellerne med 0,70 sekunder til første lyd og løser flest af arenaens opgaver med 94,6 procent. På τ-Voice ligger den dog på 56,5 procent. xAI tager 0,08 dollar pr. minut for sin Voice Agent API, og Artificial Analysis måler 4,80 dollar pr. time inputlyd.
Cascade-løsninger som ElevenLabs Agents og Deepgram Voice Agent er stadig med i arenaen. De lader dig vælge sprogmodel og stemme hver for sig, hvilket giver mere kontrol, men prisen er flere overgange og længere ventetid.
Den mest nøgterne test er Sierras τ³-Banking, hvor agenten skal finde svar i en stor, rodet videnbase og udføre flere værktøjskald i realistiske bankforløb. Extended Thinking fører med 35,1 procent foran GPT-Live-1 på 32,0 procent. Selv vinderen løser kun godt 1 ud af 3 sager. Ingen af modellerne er efter vores vurdering klar til at håndtere bank- eller forsikringssager uden en medarbejder, der godkender.
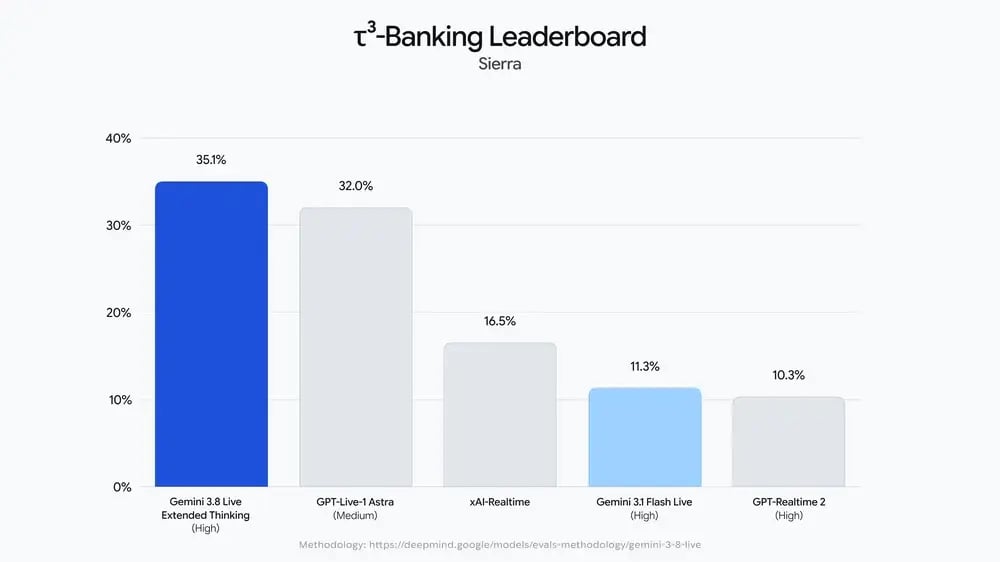
Sierras τ³-Banking: andel løste bankforløb. Grafik: Google, evalueringsnotat for Gemini 3.8 Live.
EU AI Act: det skal du selv sørge for
SynthID-vandmærket løser ikke jeres egne pligter. Bygger I en stemmeagent på Gemini 3.8 Live, er I typisk udbyder af det AI-system, kunden taler med. Efter artikel 50, stk. 1, skal kunden have at vide, at samtalen er med en AI, senest ved første interaktion. Den pligt gælder fra 2. august 2026 og blev ikke udskudt af Digital Omnibus, der kom i EU-Tidende den 24. juli 2026.
Artikel 50, stk. 2, kræver maskinlæsbar mærkning af syntetisk lyd, og det er en pligt for udbyderen af det system, der genererer lyden. I praksis leverer modellen mærkningen, her via SynthID, men skriv ind i aftalen med leverandøren, hvordan det dækker jeres løsning. Systemer, der var på markedet før 2. august 2026, har frist til 2. december 2026. Vores guide til EU AI Act gennemgår resten af reglerne.
Gemmer eller videresender I optagelserne, gælder GDPR også. I skal have et behandlingsgrundlag, informere kunden og have en databehandleraftale. Google skriver desuden, at indhold fra gratisniveauet kan bruges til at forbedre deres produkter, hvilket ikke gælder på det betalte niveau. Kundedata hører derfor kun hjemme på betalt adgang.
Hvad det betyder mandag morgen
En dansk kundeserviceagent, der slår op i ERP-systemet, mens den taler, og skifter sprog, når kunden gør, kan bygges nu. Standardmodellen gav første lyd efter 1,18 sekunder i Artificial Analysis' måling, så ventetiden er ikke længere den største hindring. Google nævner LiveKit, Pipecat, Agora, LangChain og Vercel som rammeværker med understøttelse fra første dag, så lydlaget behøver du ikke skrive selv.
Vi vil anbefale en enkel arbejdsdeling. Sæt standardmodellen i første linje, hvor samtalen skal føles naturlig og opgaverne er korte. Send de sager, der kræver flere opslag og regler, til Extended Thinking. Mål tid til første lyd, håndtering af afbrydelser og værktøjskald på jeres egne samtaler og ikke på Googles demo.
Der er også ting, vi ikke ved endnu. Google har ikke offentliggjort latens-percentiler, rate limits eller detaljer om, i hvilke regioner modellerne kører. Hverken Google eller Artificial Analysis har udgivet resultater specifikt for dansk. Test derfor med jeres egne produktnavne, adresser og ordrenumre, før I lader agenten tage imod rigtige kunder. De tekniske detaljer har vi samlet i ordbogen under Gemini 3.8 Live, og vil du have overblikket først, kan du starte med stemme-AI-agenter.
Fortsæt læsningen
Ingen af angrebene var nye. Det er hele pointen i Anthropics trusselsrapport
Den 10. september udgav Anthropic 154 sider om, hvordan folk har misbrugt Claude. Rapporten hedder Detecting and countering misuse of AI: Se…
Claude Fable 5.1 er 25% billigere. Hele rabatten ligger ét sted.
Anthropic lancerede Claude Fable 5.1 og Claude Mythos 5.1 i dag, 1. september, og den overskrift, alle citerer, er prisen: 25% billigere for…

Tre Claude-agenter fik samme opgave. Så gik de i krig med hinanden!
Anthropics Frontier Red Team gav tre Claude-agenter hver sin uforenelige ordre på den samme kodebase. Inden for få timer havde de låst hinan…