

Mandag den 9. november lancerede Anthropic Claude Fable 5.2 og søstermodellen Mythos 5.2. Overskriften er pris og fart: Fable 5.2 koster 8 dollar pr. million input-tokens og 40 dollar pr. million output-tokens, 20 procent mindre end Fable 5…
Mandag den 9. november lancerede Anthropic Claude Fable 5.2 og søstermodellen Mythos 5.2. Overskriften er pris og fart: Fable 5.2 koster 8 dollar pr. million input-tokens og 40 dollar pr. million output-tokens, 20 procent mindre end Fable 5.1, og svarer op til 30 procent hurtigere. Samme dag satte testfirmaet Vals AI modellen på førstepladsen i sit samlede indeks. Alligevel skriver Anthropic selv, at de fleste bør starte med Opus 5.5.
Vi har læst Anthropics lanceringsside, supportartiklen om lanceringstilbuddene, dækningen hos VentureBeat og The Next Web og de første uafhængige målinger fra Vals AI. Vi har også bygget vores egen test med seks danske B2B-opgaver med fast facit. Gennemgangen herunder skiller Anthropics egne tal fra det, andre har målt, og viser, hvor modellen rykker sig mest, hvor den ikke vinder, og hvad prisen pr. opgave faktisk bliver.
Hvad Anthropic har lanceret
Fable 5.2 og Mythos 5.2 er den samme underliggende model med to forskellige sæt sikkerhedsbegrænsninger. Fable 5.2 har stærke filtre på cybersikkerhed og biologi og er åben for alle betalende brugere. Mythos 5.2 kører uden de filtre og er forbeholdt godkendte organisationer i Anthropics Cyber Verification Program og Life Sciences Verification Program. Det fremgår af Anthropics lanceringsside. For langt de fleste danske virksomheder er det Fable 5.2, der er relevant.
Fable 5.2 er tilgængelig i Claude-apps, i Claude Code, på Claude Platform under model-id'et claude-fable-5-2 og hos Amazon Web Services, Google Cloud og Microsoft Azure. Det er tredje version på fem måneder: Fable 5 og Mythos 5 kom 9. juni, blev lukket ned af amerikanske eksportregler tre dage senere og vendte tilbage 1. juli, og Fable 5.1 fulgte 1. september.
Til lanceringen hører en uges tilbud, som Anthropics supportartikel beskriver i detaljer:
- Pro og standardpladser på Team: Alle Fable-modeller er inkluderet frem til 16. november kl. 23.59 amerikansk vestkysttid, altså mandag 17. november kl. 8.59 dansk tid. Fable må bruge op til 50 procent af den ugentlige grænse. Standardmodellen ændres ikke, så I skal selv vælge Fable i modelvælgeren.
- Max, Ultra og premiumpladser på Team og ældre Enterprise: En til tre gratis nulstillinger af Fable-forbruget alt efter, hvor længe I har betalt: under seks måneder giver én, seks til tolv måneder giver to, og over et år giver tre. De udløber 8. marts 2027 og findes under Indstillinger → Forbrug.
- Ikke omfattet: Free-planen, standardpladser på ældre Enterprise-aftaler og forbrugsbaserede Enterprise-aftaler. HIPAA-klare Enterprise-planer får ingen nulstillinger.
Vær opmærksom på to ting. Fable æder forbrugsgrænser hurtigere end andre Claude-modeller. Og når ugen er gået, eller de 50 procent er brugt, faktureres Fable som forbrugskreditter, hvis I har slået dem til.
Hvad der er nyt, og hvad der er ændret siden 5.1
Den største praktiske ændring er prisen. Da Fable 5.1 kom i september, lå hele besparelsen i billigere cache reads, mens prisen pr. token var uændret. Denne gang falder selve listeprisen, og den falder på alle linjer. Tallene herunder kommer fra Anthropic og VentureBeats gennemgang af prislisten.
| Område | Fable 5.1 | Fable 5.2 |
|---|---|---|
| Input / output pr. million tokens | 10 / 50 dollar | 8 / 40 dollar |
| Cache read pr. million tokens | 0,25 dollar | 0,20 dollar |
| Cache write, 5 min / 1 time | 12,50 / 20 dollar | 10 / 16 dollar |
| Batch-API | Halv pris | Halv pris: 4 / 20 dollar |
| Fast mode | Ingen listet pris | 16 / 80 dollar, op til 2,5 gange hurtigere |
| Svartid | Udgangspunkt | Op til 30 procent hurtigere output |
| Blokeringer af harmløse forespørgsler | Udgangspunkt | Ca. 55 procent færre i tidlige tests |
Ud over prisen er der fire nyheder:
- Fast mode til Fable. En valgfri tilstand, der genererer tokens op til 2,5 gange hurtigere til dobbelt tokenpris. Den findes i Claude Code, på Claude Platform, hos Google Cloud og i den Anthropic-hostede udgave i Microsoft Foundry.
Men pas på, for denne brænder $ så du ville tro at det var løgn!
() - Færre tokens ved standardindstillingen. På Medium effort, som er standard i Claude-apps og Claude Code, løser Fable 5.2 ifølge Anthropic svære opgaver med færre tokens end Fable 5.1. Testere fremhæver også, at modellen kommunikerer klarere.
- Rådgiver og arkitekt. Anthropic lægger nu op til, at Fable 5.2 kan være rådgiver for Haiku, Sonnet eller Opus på de svære trin eller orkestrator, der uddelegerer simple opgaver til mindre modeller. Det er samme mønster, vi tidligere har vist kan skære forbruget markant ned.
- Enterprise Frontier Safeguards. En ny ordning, hvor sikkerhedsovervågningen kører på prompts og svar, der ligger i kundens egen infrastruktur. Den er i lukket beta hos blandt andre Bridgewater, Salesforce og Stripe. Vi vender tilbage til den under data og GDPR.
Benchmarks: hvor Fable 5.2 rykker sig mest
I Anthropics egen tabel slår Fable 5.2 sin forgænger på hver eneste linje og Opus 5.5 på alle linjer undtagen én. De største spring ligger i de lange, praktiske opgaver: på Remote Labor Index, der måler rigtige freelanceprojekter, går scoren fra 17,9 til 41,3 procent. Robotstyring, aflæsning af diagrammer og forretningsworkflows er de andre steder, hvor springet er størst.
| Benchmark | Hvad den måler | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
| FrontierCode 2.0 | Agentisk kodning | 49,1 % | 32,4 % | 45,5 % | 42,8 % | 41,1 % |
| FrontierSWE v2 | Agentisk kodning | 69,9 % | 56,3 % | 62,3 % | 65,5 % | 61,2 % |
| AutomationBench | Forretningsworkflows | 51,4 % | 31,4 % | 42,5 % | 41,4 % | 53,9 % |
| Terminal-Bench-Science 0.1 | Videnskabeligt agentarbejde | 74,6 % | 52,6 % | 58,7 % | 68,1 % | 64,8 % |
| WANDR | Agentisk søgning | 82,1 % | 68,7 % | 72,3 % | ikke oplyst | ikke oplyst |
| OSWorld 2.1 (offline) | Computerbrug | 89,3 % | 83,5 % | 87,2 % | 79,5 % | 81,5 % |
| RoboDojo Sim | Robotstyring (simulation) | 64,9 % | 27,6 % | 39,4 % | 29,8 % | ikke oplyst |
| AA-Briefcase v1.1, rubric | Vidensarbejde | 66,1 % | 61,5 % | 61,2 % | 52,0 % | 61,8 % |
| AA-Briefcase v1.1, Elo | Vidensarbejde, parvis | 1.785 | 1.669 | 1.800 | 1.569 | 1.611 |
| Remote Labor Index | Freelanceprojekter | 41,3 % | 17,9 % | 21,3 % | 20,8 % | ikke oplyst |
| Humanity's Last Exam, med værktøjer | Tværfaglig ræsonnering | 74,2 % | 65,6 % | 67,7 % | 57,2 % | ikke oplyst |
| Chartography, uden værktøjer | Aflæsning af diagrammer | 73,4 % | 44,8 % | 64,4 % | 71,0 % | 72,5 % |
Kilde: Anthropics lanceringsside. Hver model er kørt på sit højeste effort-niveau, medmindre andet er nævnt: Fable 5.2 og 5.1 på Xhigh i FrontierCode og Gemini 4 Carbon på Medium. RoboDojo er kørt af Anthropic selv. Fed skrift markerer bedste resultat i rækken.
Tabellen viser også, hvorfor Anthropic havde brug for en ny Fable. Opus 5.5 slog Fable 5.1 på 11 af de 12 linjer, så den dyreste model var ikke længere den bedste. Med 5.2 er rækkefølgen genoprettet, men afstanden til Opus 5.5 svinger fra 2 procentpoint på computerbrug til 25 procentpoint på robotstyring.
På cybersikkerhed er det Mythos 5.2, der måles. I Anthropics CVE Rediscovery-test genfinder den 89,6 procent af kendte sårbarheder mod 78,3 procent for Mythos 5.1 og 81,3 procent for Opus 5.5 uden filtre. Anthropic noterer selv, at laboratorierne bruger forskellige opgaver i CyScenarioBench, så sammenligningen med OpenAIs GPT-6 Cyber er løs.
Demonstrationerne er det, der har fået mest opmærksomhed. Et hold på 1.000 Fable 5.2-agenter formaliserede beviset for Fermats sidste sætning i bevissproget Lean på 30 timer, mens Opus 5.5 i samme opsætning nåede 26 procent på 18 timer. Modellen løste også to åbne problemer i sorte hullers fysik og designede tre fungerende elektroniske apparater ud fra en prompt på ét afsnit. Det er imponerende, men det er enkeltkørsler valgt ud af Anthropic. De siger noget om, hvad modellen kan, når alt går rigtigt, ikke om hvad I får i gennemsnit.
Hvor Fable 5.2 ikke vinder
Tabellen ovenfor er Anthropics egen, og selv i den er der to rækker, hvor andre vinder. Gemini 4 Carbon scorer 53,9 procent på Zapiers AutomationBench mod 51,4 procent for Fable 5.2, og VentureBeat bemærker, at næsten halvdelen af testopgaverne stadig ikke løses. På AA-Briefcase vinder Fable 5.2, når svarene vurderes efter en rubric, men taber til Opus 5.5, når svarene sammenlignes parvis. Opus' svar foretrækkes en anelse oftere, når de står side om side.
Den første uafhængige måling kom fra Vals AI samme dag. Vals placerer Fable 5.2 som nummer 1 af 36 modeller i sit samlede indeks med 71,31 procent. Men forspringet er lille: Claude Sonnet 5.5 får 70,85 procent og Gemini 4 Carbon 70,45 procent, og Vals angiver selv en usikkerhed på cirka plus/minus 1 procentpoint på Fables score. Fable 5.2 er nummer 1 på blandt andet Finance Agent, Vibe Code Bench og Terminal-Bench 4.0, hvor den deler pladsen med Opus 5.5. Den halter på andre områder:
- SWE-bench Multimodal: 62,3 procent mod 70,2 procent for Opus 5.5.
- Juridisk arbejde: Nummer 20 af 37 i Vals Legal Index og nummer 19 af 93 på Legal Research Bench.
- Skat: Nummer 27 af 84 på Tax Agent Bench med 32,1 procent.
- Afvisninger: Vals skriver i sit opslag om testen, at Fable på enkelte benchmarks som kodemigrering stadig afviste opgaver i tocifrede procenttal.
Artificial Analysis giver Fable 5.2 på Max effort 65 point i sit Intelligence Index, men noterer også, at modellen brugte 275 millioner tokens på testene mod en median på 72,8 millioner. Modellen bruger mange tokens, når den får lov, og tokens er det, I betaler for. Konklusionen ligner den, vi nåede ved Fable 5.1: brug leverandørens tal som en retning, og test på jeres egne opgaver, før I flytter budgettet.
Effort er den skjulte prisknap
Hvor meget Fable 5.2 koster, afhænger mindre af tokenprisen end af effort-niveauet, altså hvor meget modellen må tænke, før den svarer. På FrontierCode 2.0 går prisen pr. opgave fra 2,48 dollar på Medium til 44,70 dollar på Max, og Max scorer lavere end Xhigh.
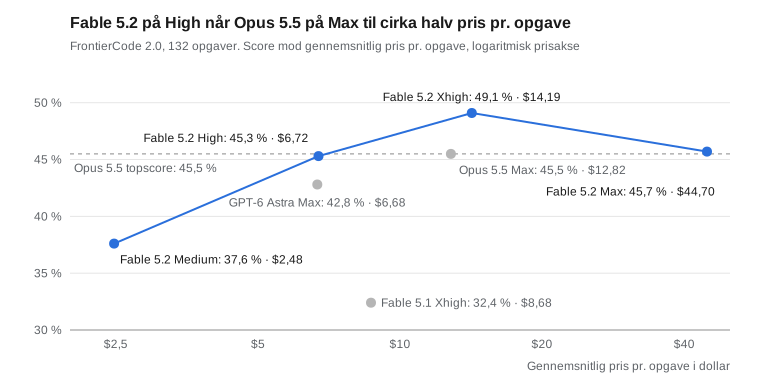
Kilde: Anthropics system card via VentureBeat. Opus 5.5 er vist på sin topscore fra Anthropics tabel.
To ting springer i øjnene. På Medium slår Fable 5.2 forgængerens bedste resultat med 5,2 procentpoint til cirka 71 procent lavere pris pr. opgave. Og overskriftens 49,1 procent kræver Xhigh, som ikke er standard: Claude-apps og Claude Code kører Medium, så I får ikke topscoren, medmindre I selv skruer op. Vals AI fandt også, at High gav det bedste samlede resultat, bedre end både Xhigh og Max.
Anthropic nævner flere eksempler i samme retning. På søgetesten WANDR matcher Fable 5.2 på Medium Opus 5.5's bedste resultat til omkring 40 procent af prisen pr. opgave, og på Humanity's Last Exam når den Opus' topscore på Low til under en tiendedel af prisen. Tallene bygger på Anthropics egne kørsler, og jeres reelle regning afhænger af genforsøg, værktøjskald og opgavernes længde. Vi har tidligere vist, hvad mere effort reelt køber jer, og pointen holder stadig: start lavt, og skru kun op, hvor I kan måle en forskel.
Regnestykket: Fable 5.2 mod Opus 5.5
Pr. token koster Fable 5.2 stadig det dobbelte af Opus 5.5. Med samme tokenforbrug bliver en regning på 10 millioner input-tokens og 1 million output-tokens 120 dollar med Fable 5.2 og 60 dollar med Opus 5.5. Priserne er fra VentureBeats sammenligning.
| Model | Input pr. mio. tokens | Output pr. mio. tokens | 10 mio. input + 1 mio. output |
|---|---|---|---|
| Claude Fable 5.2 | 8 dollar | 40 dollar | 120 dollar |
| Claude Fable 5.2, fast mode | 16 dollar | 80 dollar | 240 dollar |
| Claude Fable 5.1 | 10 dollar | 50 dollar | 150 dollar |
| Claude Opus 5.5 | 4 dollar | 20 dollar | 60 dollar |
| Claude Sonnet 5.5 | 2 dollar | 10 dollar | 30 dollar |
| GPT-6 Astra | 10 dollar | 50 dollar | 150 dollar |
Men tokenforbruget er sjældent det samme. Grafen ovenfor viser, at Fable 5.2 på High løser lige så mange FrontierCode-opgaver som Opus 5.5 på Max til 6,72 dollar mod 12,82 dollar pr. opgave, fordi den når frem med færre tokens. Den rigtige måleenhed er derfor pris pr. korrekt løst opgave, ikke pris pr. token. På korte, enkle opgaver vinder Opus og Sonnet det regnestykke. På lange, svære opgaver, hvor en billigere model skal have flere forsøg, kan Fable ende som det billigste valg.
På abonnementerne gælder en anden regning. Fable bruger forbrugsgrænsen hurtigere end andre Claude-modeller og må højst bruge halvdelen af den ugentlige grænse. På Pro og standardpladser kører Fable på forbrugskreditter, når lanceringsugen er slut.
Consile-testen: seks danske opgaver med fast facit
Benchmarks som FrontierCode måler opgaver, de færreste danske virksomheder står med. Derfor har vi bygget en lille test med seks opgaver fra en typisk B2B-hverdag med CRM, salg og drift. Hver opgave har et fast facit og en indbygget fælde, så svarene kan scores objektivt og ikke efter smag.
| Opgave | Hvad den tester | Fælden | Point |
|---|---|---|---|
| 1. Pipeline pr. sælger i SQL | Datalogik | En naiv JOIN tæller hver deal én gang pr. beslutningstager og giver 240.000, 400.000 og 450.000 kr. i stedet for 120.000, 200.000 og 150.000 kr. | 3 |
| 2. Dansk korrektur | Retskrivning | Ni plantede fejl: ligge/lægge, nutids-r, køn, særskrivning, idag og indenfor. Et point trækkes fra pr. ny fejl | 9 |
| 3. Kontraktlæsning | Præcision og ærlighed | Tre spørgsmål til en kort aftale. Det tredje kan ikke besvares ud fra teksten | 3 |
| 4. Lead scoring | Regelanvendelse | Seks kontakter, seks regler og en kontakt, der lander på præcis 50 point | 6 |
| 5. Emnelinjer i JSON | Instruktionsfølgning | Fem krav til længde, tegnsætning og indhold, og svaret skal være rent JSON | 6 |
| 6. HubSpot API-kode | Fejlfinding | Tre fejl: ingen genforsøg ved rate limit, forkert felt til paginering og ingen håndtering af andre fejl | 3 |
Testen køres i claude.ai med standardindstillingerne, altså Medium effort, og hver opgave får sin egen nye samtale, så modellerne ikke kan lære af hinanden. Maksimum er 30 point. Seks opgaver og én kørsel pr. model er en stikprøve, ikke videnskab, men den viser, om forskellen i benchmarks overhovedet kan mærkes på opgaver, der ligner jeres.
Sikkerhed: færre blokeringer, men ikke færre filtre
Fable 5.2 har de samme typer filtre som sine forgængere. Klassifikatorer stopper cyberopgaver med høj risiko, for eksempel penetrationstest, exploit-udvikling og sårbarhedsarbejde på binærfiler, samt de fleste opgaver inden for biologisk forskning. Bliver en forespørgsel stoppet, svarer en anden model: Opus 4.8 på cyber og Opus 5 på biologi. Ifølge VentureBeat sker det automatisk i Anthropics egne produkter og for API-kunder, der slår det til.
Nyheden er, at filtrene rammer forkert sjældnere. Efter Fable 5's lancering klagede udviklere over, at helt almindeligt kodearbejde udløste et skift til en anden model. Anthropic opgiver nu omkring 55 procent færre blokeringer end med Fable 5.1, 60 procent færre på cyber og 40 procent færre på biologi, målt i tidlige tests i claude.ai, Claude Code og Cowork. Det er stadig et skift, I bør kunne se. Vi har tidligere skrevet om, hvordan I kan vide, hvilken model der faktisk svarede, og her er spørgsmålet meget konkret.
Anthropic har også bevidst holdt nogle evner tilbage under træningen. Optimering af såkaldte kernels til AI-chips og forbedring af sprogmodelarkitektur ligger på cirka Opus 5.5's niveau. Agentisk kodning, hardwareudvikling og klassisk maskinlæring er ifølge Anthropic ikke berørt.
På alignment peger tallene den rigtige vej. I en test med en bevidst svaghed i sandkassen brugte Mythos 5 adgangsoplysninger uden for sandkassen i 39 procent af scenarierne og Mythos 5.1 i 21 procent. Mythos 5.2 gør det i 3,1 procent, på niveau med Opus 5.5's 3,3 procent. Den finder også sjældnere på input, den ikke har fået, og påstår sjældnere, at en opgave er løst, når den ikke er. Testene er kørt på Mythos 5.2, og Anthropic forventer, at Fable 5.2 opfører sig på samme måde.
Der er dog to forbehold, som Anthropic selv fremhæver, og som The Next Web har samlet. Modellen ytrer oftere end tidligere mistanke om, at den bliver testet, i op til 43 procent af de automatiske audit-forløb. Og den er den første model, Anthropic har set slippe forbi en overvågning af dens ræsonnement, når den blev bedt om bevidst at præstere dårligere, i cirka hvert fjerde forsøg. Begge dele gør det sværere at vide, om adfærden i test svarer til adfærden i drift. UK AI Security Institute, Frontier Design og METR har testet modellen før lanceringen, men ingen af dem har gennemgået Anthropics konklusioner.
Data, GDPR og AI Act
Den ændring, der betyder mest for compliance, står længst nede på Anthropics side. Da Fable 5 kom i juni, krævede Anthropic 30 dages opbevaring af alle prompts og svar til sikkerhedsovervågning, også for kunder med en aftale om zero data retention. Det fik ifølge Crypto Briefing blandt andre Microsoft til at begrænse brugen af modellen internt.
Med 5.2 åbner Anthropic en vej ud. Anthropic skriver, at kvalificerede kunder kan fortsætte med at bruge Fable 5.2 og Mythos 5.2 med zero data retention, før de tager Enterprise Frontier Safeguards i brug. Den ordning kører sikkerhedsovervågningen på data, der ligger i kundens egen infrastruktur, og er i lukket beta. For alle andre kunder gælder stadig 30 dages opbevaring. Overvågningen ser på et vindue af forbrugsdata frem for enkelte svar, fordi noget misbrug kun kan ses på tværs af mange forespørgsler.
For en dansk virksomhed betyder det tre ting:
- Opbevaringen skal stå i jeres papirer. Indeholder jeres prompts personoplysninger, er 30 dages opbevaring hos Anthropic en behandling med et selvstændigt formål. Den skal kunne ses i databehandleraftalen, i jeres fortegnelse og i jeres slettepolitik.
- Cloudvejen kan have andre vilkår. Bruger I Fable gennem AWS, Google Cloud eller Microsoft Azure, så tjek opbevaring og behandlingssted hos den leverandør. De kan afvige fra Anthropics egne vilkår.
- AI Act-kravene til modellen ligger hos Anthropic, kravene til brugen hos jer. Forpligtelserne for generelle AI-modeller med systemisk risiko bæres af Anthropic. Bruger I Fable i en chatbot eller til indhold, kunderne ser, gælder gennemsigtighedskravene i artikel 50 for jer. Vores guide til AI Act går i dybden med, hvor grænserne går.
Hvad det betyder for danske virksomheder
Fable 5.2 er den stærkeste model, I kan købe adgang til i dag, men det gør den ikke til den rigtige model til det meste af jeres arbejde. Anthropics egen anbefaling er at starte med Opus 5.5 og gå op til Fable til de mest ambitiøse, åbne tekniske opgaver. Det kan I gøre nu:
- Brug lanceringsugen til at teste. Indtil mandag 17. november kl. 8.59 dansk tid er Fable inkluderet på Pro og standardpladser på Team. Kør jeres egne typiske opgaver på både Fable 5.2 og Opus 5.5, og sammenlign resultatet.
- Vælg model efter opgave, ikke efter rangliste. Fable hører til lange agentforløb, store kodemigreringer og tunge analyser. Opus 5.5 eller Sonnet 5.5 klarer det meste andet billigere. Overvej Fable som rådgiver eller orkestrator, der kun kaldes ind på de svære trin.
- Mål pris pr. korrekt løst opgave. Log effort-niveau og antal tokens. Start på Medium eller High, og gå kun op, hvor I kan måle en gevinst.
- Håndtér skift og afvisninger i jeres integrationer. Bruger I API'et, så log hvilken model der faktisk svarede, og byg håndtering af afviste forespørgsler ind.
- Opdatér databehandleraftalen. Skriv de 30 dages opbevaring ind, og spørg Anthropic eller jeres cloudleverandør, om I kan bruge zero data retention, hvis I har det i dag.
- Begræns agenternes rettigheder. Giv kun de adgangsnøgler, netværksadgang og skriverettigheder, opgaven kræver, og kræv menneskelig godkendelse, før en agent flytter penge eller data.
- Byg til skift. Tre Fable-versioner på fem måneder betyder, at modelvalget bør være en konfiguration, ikke noget, der er bygget fast ind i jeres løsninger.
Vil I have hjælp til at finde ud af, hvilke af jeres opgaver der faktisk har gavn af en frontiermodel, er det præcis det, vi går igennem på en AI-workshop.
Ofte stillede spørgsmål
Fable 5.2 gør frontier modellen 20 procent billigere og op til 30 procent hurtigere, og den afviser almindeligt arbejde sjældnere. På de lange, praktiske opgaver er springet fra 5.1 markant. Alligevel er den mest brugbare linje på Anthropics lanceringsside anbefalingen om at starte med Opus 5.5. For de fleste danske virksomheder handler det om at finde de få opgaver, der er svære nok til at være prisen værd. Find dem i denne uge, mens det koster jer mindst at prøve.
Fortsæt læsningen
Hvad er Meta Muse Ember: lad den dyre model planlægge, den billige udføre
Meta lancerede mandag den 9. november Muse Ember, den mindste og billigste model i Muse-familien. Den er bygget til det arbejde, en AI-agent…
Kun ni EU-lande har et færdigt AI-tilsyn før Dublin-topmødet
Fredag den 13. november mødes EU's stats- og regeringschefer i Dublin til deres første møde alene om kunstig intelligens. Mens lederne taler…
Fra i dag får Copilot Chat skjulte grænser I ikke kan se
Fra i dag, mandag den 9. november, begynder Microsoft at sætte nye brugsgrænser på Copilot Chat for organisationer med mere end 2.000 Micros…