

Claude Mythos 5.2 er Anthropics mest kapable model til cybersikkerhed, udgivet 9. november 2026. Det er samme underliggende model som Claude Fable 5.2, men uden en række af de safeguards, der ellers holder en offentlig model tilbage på neto…
Claude Mythos 5.2 er Anthropics mest kapable model til cybersikkerhed, udgivet 9. november 2026. Det er samme underliggende model som Claude Fable 5.2, men uden en række af de safeguards, der ellers holder en offentlig model tilbage på netop sikkerhedsarbejde, og adgangen er derfor begrænset til godkendte organisationer. Consile er en af dem. Vi er godkendt gennem Anthropics Cyber Verification Program og har Mythos 5.2 via API.
Det lyder som en teknisk detalje, men forskellen er mærkbar i praksis. Vi satte modellen til at gennemgå vores eget produkt, consile.ai, og den pegede på to områder med sårbarheder, som hverken Fable eller Opus selv havde fanget. Vi har læst Anthropics egne sider om modellen og om programmet, og herunder forklarer vi, hvad Mythos 5.2 er, hvorfor adgangen er låst, hvad vi er godkendt til, og hvad modellen konkret fandt, da vi vendte den mod vores egen kode.
Hvad er Claude Mythos 5.2?
Claude Mythos 5.2 er en frontier-cybermodel, altså en af de kraftigste modeller på markedet målrettet cyberarbejde. Anthropic beskriver den som selskabets mest kapable model til cybersikkerhed og biologiforskning. Det usædvanlige er, at den ikke er en ny model i egen ret. Mythos 5.2 og Claude Fable 5.2, den offentlige model alle kan bruge, er ifølge Anthropic den samme underliggende model. Forskellen ligger i modellens safeguards.
En safeguard er en indbygget spærring, der får modellen til at afvise eller nedtone en opgave, som kan misbruges. På en offentlig model som Fable griber de ind på præcis den slags cyberarbejde, hvor en forkert hånd kan gøre skade: at kortlægge en sårbarhed i detaljer eller skrive kode, der udnytter den. Mythos er den samme model med de spærringer fjernet, og den er kun i hænderne på organisationer, Anthropic har tjekket. Med Anthropics egne ord afspejler forskellen i resultater "tasks where Fable 5.2’s safeguards intervene", altså opgaver, hvor den offentlige models spærringer slår til.
Mythos-linjen er ny. Anthropic åbnede den første Mythos 5 for en lille kreds i juni 2026, og 5.2 kom 9. november sammen med Fable 5.2. På Anthropics egen interne evaluering, CVE Rediscovery, finder 5.2 flere kendte sårbarheder end både forgængeren og den almindelige topmodel. Anthropic oplyser, at modellen fandt 10,2 procent flere sårbarheder end Claude Opus 5.5 og 14,4 procent flere end Mythos 5.1. Det er selskabets egne tal på egen test, ikke en uafhængig måling, og en fodnote på samme side noterer, at modellen på andre af Anthropics evalueringer ligger nogenlunde på niveau med Opus 5.5. Men retningen er til at få øje på: en model bygget til at finde sårbarheder finder flere af dem.
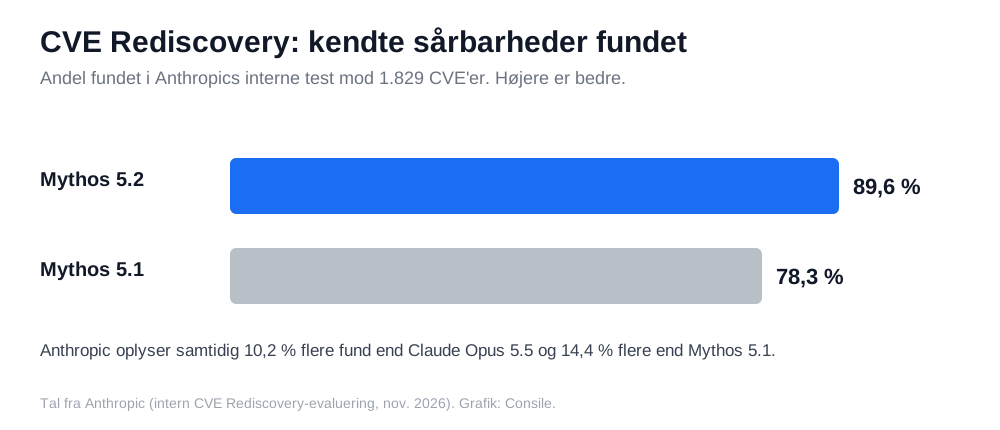
CVE Rediscovery, Anthropics interne evaluering. Tal fra Anthropic, grafik: Consile.
Derfor er adgangen begrænset: Cyber Verification Program
Grunden til, at Mythos ikke bare ligger frit, er dobbeltbrug. De samme evner, der gør en model god til at finde huller, så de kan lukkes, gør den også god til at finde huller, der kan udnyttes. Derfor har Anthropic lagt adgangen ind under sit Cyber Verification Program, som selskabet udvidede 6. oktober 2026 og lagde det tidligere Project Glasswing ind under.
Programmet har tre niveauer, og forskellen mellem dem er, hvad man må bruge modellerne til, og hvor mange af spærringerne der er justeret.
- Defense Access er det defensive niveau. Det dækker security operations, incident response, analyse af malware, detection engineering og det at finde og validere sårbarheder.
- Red Team Access lægger autoriseret penetrationstest og red teaming oven i det defensive: at angribe systemer, man har tilladelse til at teste, for at finde svaghederne, før andre gør. Niveauet er kun for organisationer, ikke enkeltpersoner.
- Specialized Access er det snævreste niveau med færrest spærringer, forbeholdt en begrænset kreds, der arbejder med kritisk infrastruktur. Anthropic vurderer de ansøgere i samarbejde med amerikanske myndigheder.
På alle tre niveauer får man adgang til de samme modeller, blandt andet Mythos, Opus og Sonnet. Det, der varierer, er spærringerne og det tilladte arbejde, ikke hvilke modeller man kan kalde.
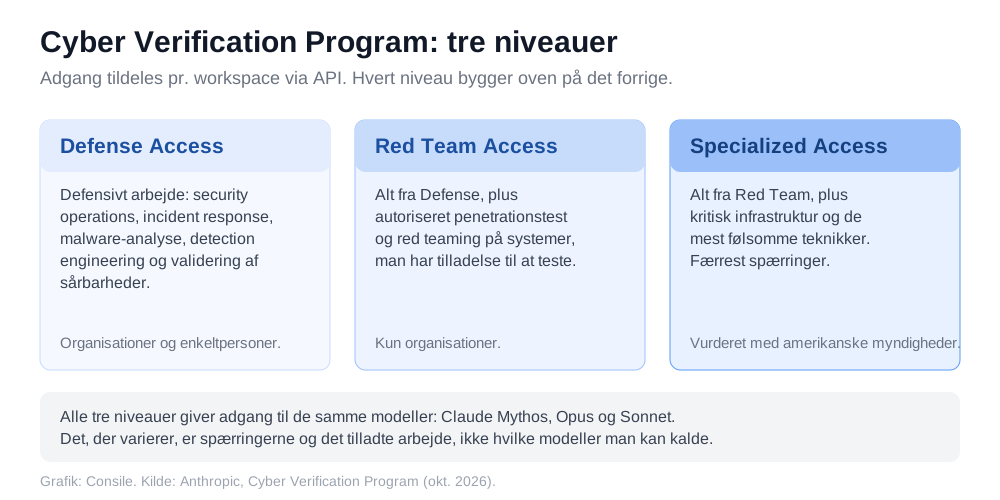
De tre adgangsniveauer i Cyber Verification Program. Grafik: Consile.
Adgangen er ikke en knap, der tændes af sig selv. En administrator i organisationen tildeler den til et bestemt workspace i Claude Console, og derfra kan modellen kaldes via API’et. Anthropic oplyser, at adgang til Mythos hos cloud-partnere starter cirka fem hverdage efter en godkendelse.
At dobbeltbrugen er reel, har vi set før. Da OpenAI svarede igen med sin egen cybermodel som modsvar til Mythos, var mønsteret det samme: de stærkeste evner holdes tilbage bag en adgangskontrol. Vi har også beskrevet, hvordan Claude i en test gennemførte et angreb på tre virksomheder og selv troede, det var en øvelse. Det er den slags kraft, programmet forsøger at holde i de rigtige hænder.
Consile er godkendt til Mythos 5.2
Consile er godkendt til Defense Access, og Mythos 5.2 er aktiv i vores eget workspace via API. I praksis betyder det, at vi kan bruge den stærkeste cybermodel til det defensive arbejde, niveauet dækker: at gennemgå kode for sårbarheder, vurdere et muligt fund, analysere mistænkelig adfærd og bygge detektion.
Det er den type AI-cybersikkerhed, vi i forvejen arbejder med, nu med en model, der er bygget til formålet fremfor en almindelig model, der hele tiden støder på sine egne spærringer.
Adgangen dækker to ting hos os. Den ene er vores eget arbejde: vores egen kode og vores egne systemer. Den anden er konkrete kundeopgaver, men dem kører vi ikke frit. Som godkendt organisation i programmet søger vi godkendelse hos Anthropic pr. sag, før en kundeopgave sættes på Mythos.
Det er en bevidst tærskel. En model med færre spærringer kræver, at vi er tydelige om, hvad den må bruges til, og for hvem.
Hvad modellen fandt i consile.ai
Det første sted, vi satte Mythos 5.2 ind, var vores eget produkt, consile.ai. Formålet var enkelt: at lukke sikkerhedshuller, før nogen anden fandt dem. Vi havde tidligere kørt den samme kode gennem både Fable og Opus, de offentlige modeller, uden at de pegede på noget alvorligt.
Mythos fandt to områder med sårbarheder, som de to andre modeller ikke selv havde fanget. Vi går ikke i detaljer med, hvad de to fund var. At beskrive en åben sårbarhed offentligt hjælper kun den forkerte, og begge områder er lukket. Det interessante for den her artikel er, hvorfor den ene model så dem, når de andre ikke gjorde.
Svaret er de safeguards, vi beskrev tidligere. For at følge et muligt hul til dørs skal en model tænke som en angriber: hvor kan det udnyttes, hvad skal der til, hvor langt rækker det. Det er præcis den tankegang, de offentlige modellers spærringer dæmper, fordi den også kan misbruges. Fable og Opus holdt sig tilbage på netop det skridt. Mythos, der er sluppet for spærringerne og kun er i hænderne på godkendte organisationer, gik hele vejen. Det er ikke, at Mythos er en klogere model end Fable. Det er den samme model, der får lov at bruge evnerne på en opgave, hvor den offentlige udgave trækker sig.
Sådan bruger vi den, og hvor et menneske vurderer
Hos os er modellens output altid et udgangspunkt, som et menneske skal vurdere. Mythos peger på et muligt problem og forklarer, hvorfor det kan være et problem. En af vores folk vurderer så, om fundet holder, hvor alvorligt det er, og hvad der skal gøres, og først derefter bliver det til en rettelse. Modellen gør gennemgangen hurtigere og mere grundig, men den afgør ikke.
Der er også en faldgrube at kende. En model, der læser kode og konfiguration, læser også det, andre har skrevet, og er dermed sårbar over for prompt injection, hvor skjulte instruktioner i inputtet forsøger at styre modellen. Vi behandler et fund fra Mythos som et kvalificeret udgangspunkt, der skal efterprøves. Det er den samme arbejdsdeling, vi anbefaler alle steder, hvor en agent er involveret: mennesket sætter målet og godkender, modellen gør det tunge arbejde.
Det defensive arbejde er den ene halvdel. Programmets næste niveau, Red Team Access, åbner for den anden: autoriseret penetrationstest og red teaming. Hvor den defensive brug gennemgår et system indefra for at finde svagheder, vender red teaming perspektivet om og angriber systemet udefra, som en reel modstander ville, men med tilladelse og inden for en aftalt ramme. For et system, der skal holde, er de to tilgange hinandens kontrol: den ene finder, hvad der ser forkert ud i koden, den anden finder, hvad der rent faktisk kan udnyttes. En model som Mythos gør begge dele hurtigere.
Pris, dataopbevaring og det, vi ikke lover
Adgangen koster. Mythos 5.2 starter ifølge Anthropic på 8 dollar pr. million input-tokens og 40 dollar pr. million output-tokens. Det er dyrere end en almindelig model, og en hurtigere tilstand koster det dobbelte. Oven i prisen kommer et vilkår, der er værd at kende: brug af Mythos kræver som udgangspunkt 30 dages dataopbevaring, så Anthropic kan overvåge for misbrug. Det er en del af prisen for en model med færre spærringer, og en af grundene til, at vi er bevidste om, hvilke data der overhovedet skal den vej.
Så er der det, vi ikke lover. Mythos finder ikke alt, og et rent resultat er ikke et bevis for, at koden er sikker, kun at modellen ikke fandt noget denne gang. Et fund er et kvalificeret udgangspunkt, som et menneske skal bekræfte. Godkendelsen gælder det, den gælder: det defensive arbejde under Defense Access, og kundeopgaver kun efter godkendelse pr. sag. Vi bruger ikke modellen til mere, end vi er godkendt til, og det er netop pointen med et program, der deler adgang ud i niveauer.
Ofte stillede spørgsmål
Det interessante ved Mythos 5.2 ligger lige så meget i adgangen som i modellen. De samme evner deles ud med forskellig frihed alt efter, hvem der sidder med dem. For os er værdien konkret: en model, der på vores eget produkt så noget, de offentlige modeller ikke måtte, og en arbejdsgang, hvor et menneske har sidste ord. Sådan mener vi en kraftig cybermodel skal bruges: tæt på arbejdet og under menneskelig kontrol.
Fortsæt læsningen
Gemini Decisions API: 1.000 kalibrerede beslutninger i ét kald
Google lancerede onsdag den 11. november Gemini Decisions API, et nyt endpoint, der er bygget til én ting: at træffe mange små beslutninger …
Digital Fairness Act: EU giver kunden kontrol over AI-agenten
Europa-Kommissionen fremlagde 11. november sit forslag til en Digital Fairness Act. De fleste overskrifter handler om dark patterns, abonnem…
EU's AI-sandkasser: gratis for SMV'er og ingen bøder i god tro
Europa-Kommissionen har vedtaget fælles regler for, hvordan virksomheder kan teste AI-systemer sammen med myndighederne, før systemerne komm…