
En subagent er en AI-agent med sit eget kontekstvindue, sine egne værktøjer og sine egne instruktioner, som en hovedagent sender en afgrænset opgave til. Den 22. oktober 2026 udgav Anthropic en guide, der opfordrer virksomheder til at folde…
En subagent er en AI-agent med sit eget kontekstvindue, sine egne værktøjer og sine egne instruktioner, som en hovedagent sender en afgrænset opgave til. Den 22. oktober 2026 udgav Anthropic en guide, der opfordrer virksomheder til at folde de fleste af dem ind i én agent med skills. Ifølge Anthropics Applied AI-team slog én agent med skills ofte både den store fælles prompt og subagent-designet på kvalitet, tit med lavere pris og kortere ventetid pr. opgave.
Det her er en masterclass i det nye agentdesign. Du får definitionerne, de 5 fejl, Anthropic ser i store organisationer, de 3 situationer, hvor subagenter stadig vinder, og de 4 trin til at folde dem ind, med et eksempel på et testsæt og en skill. Undervejs lægger jeg vores egne 2 opsætninger ved siden af. Jeg er enig i det meste, men Anthropics liste mangler én grund til at beholde subagenter: pris.
Hvad Anthropic anbefaler i det nye agentdesign
Guiden er skrevet af Diane Sarkis fra Claude Platform og bygger på det, Anthropics Applied AI-team har set i virksomhedernes agentprojekter. Anthropic kalder subagenter stærke til at kontrollere andres arbejde, til parallelt arbejde og til at dele rettigheder op, og bruger dem selv i sit researchsystem. Problemet er et mønster, hvor hvert team eller hver problemtype får sin egen subagent, så agentens arkitektur ender som en kopi af organisationsdiagrammet. Anthropic kalder det Conways lov i aktion, efter den gamle iagttagelse om, at systemer kommer til at ligne strukturen i den organisation, der bygger dem.
Guiden beskriver et design, Anthropic ofte får forelagt. Det består af en klassifikator, der gætter brugerens hensigt, en fast tænke-pipeline i flere trin, separate spor for hvert kundesegment, separate anbefalingsgrene og øverst en orkestrator, der styrer det hele. Det er 5 lag struktur rundt om modellen. Anthropics vurdering er, at det meste af den struktur laver arbejde, som modellen ikke længere har brug for hjælp til. En klar systemprompt, 4-5 tynde dataværktøjer og faste rammer for svaret dækker ifølge guiden det meste af behovet.
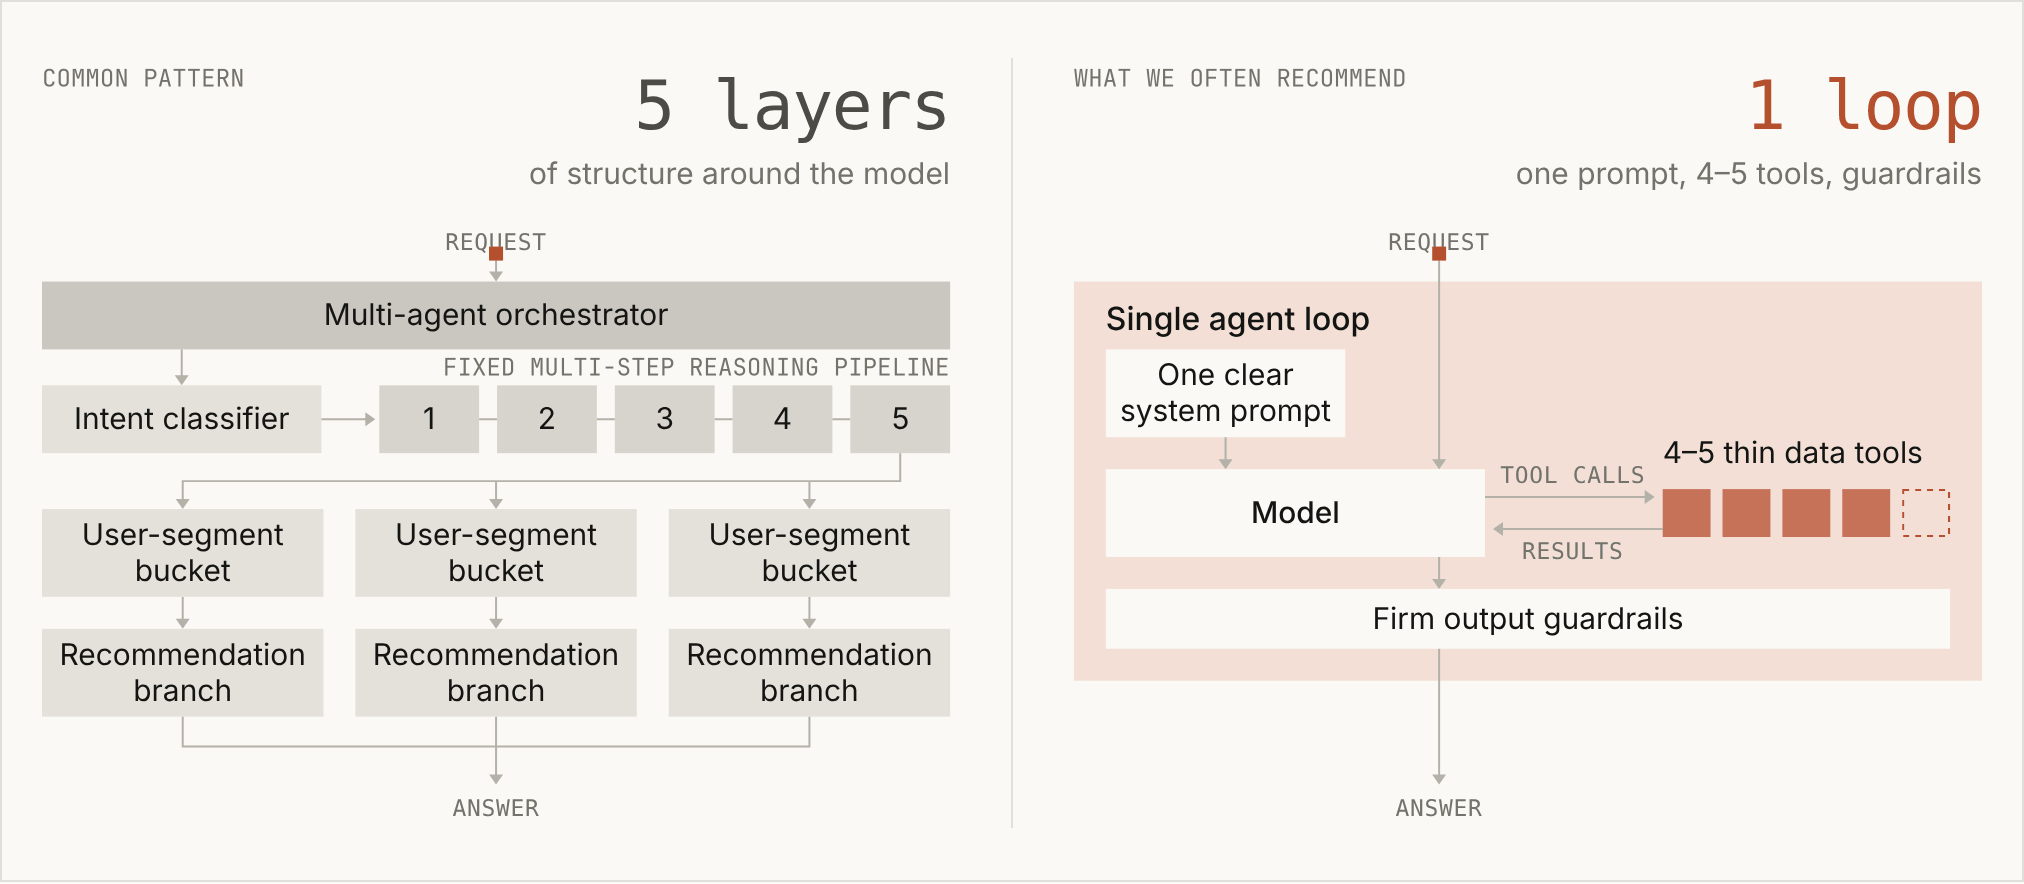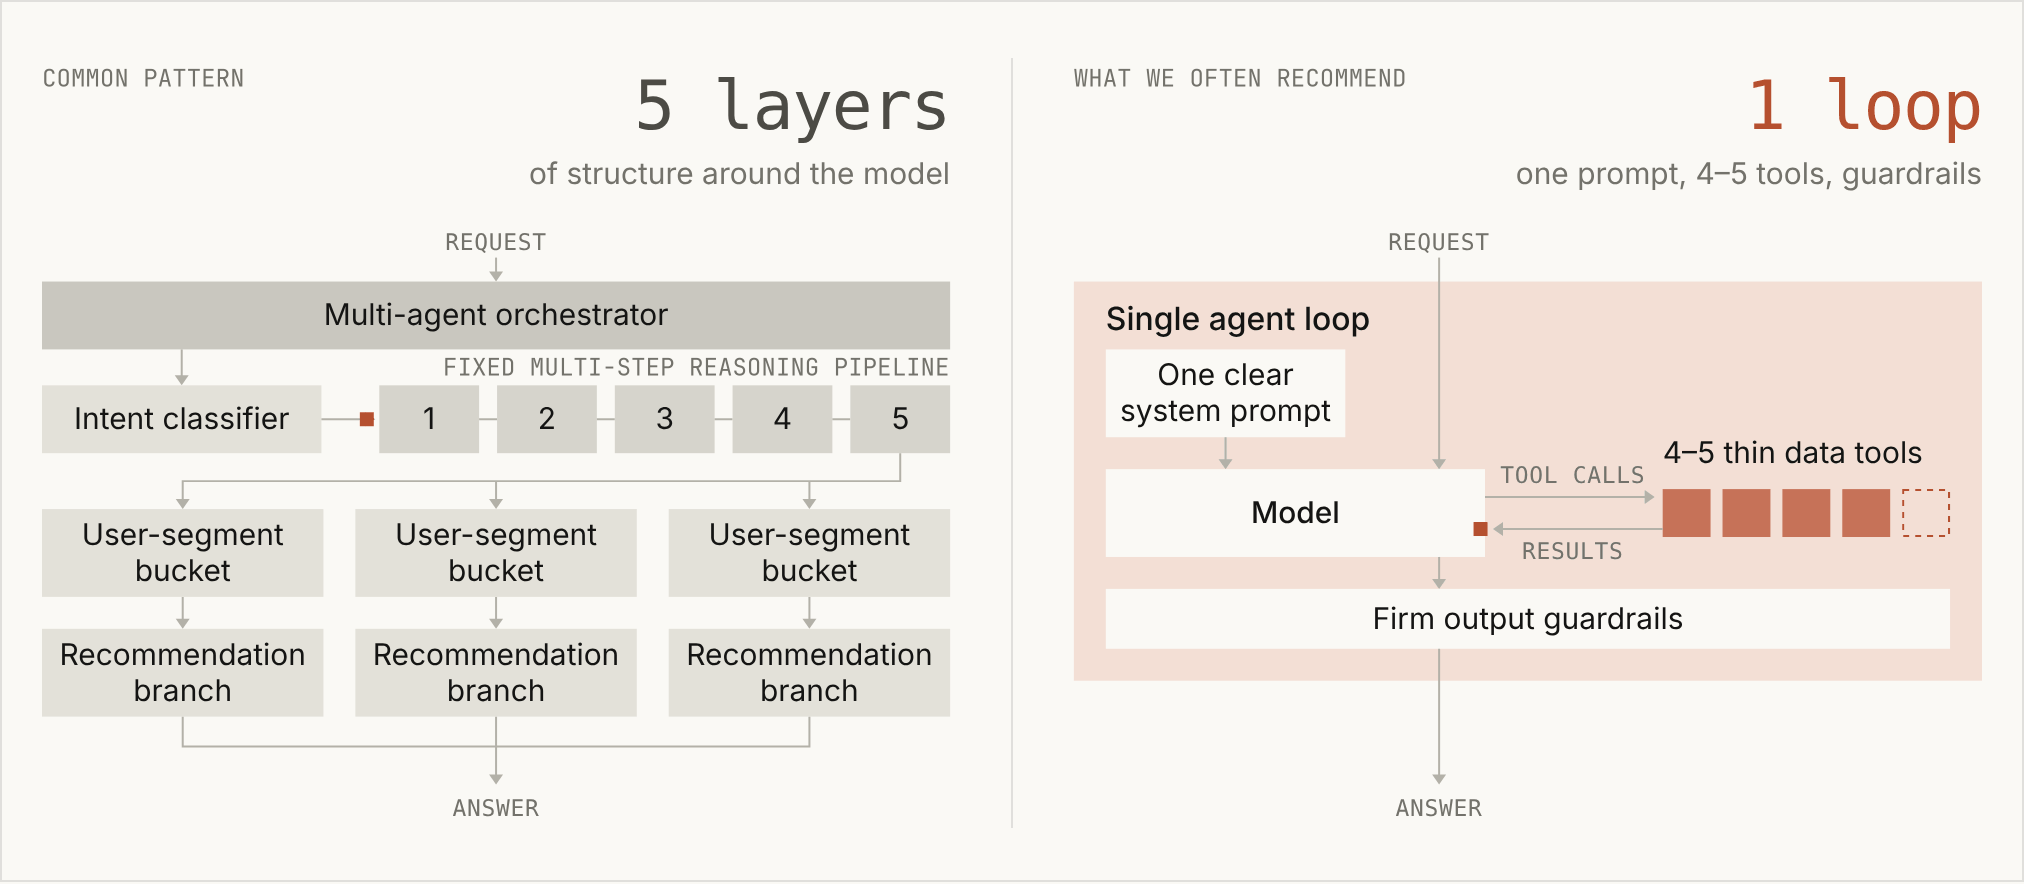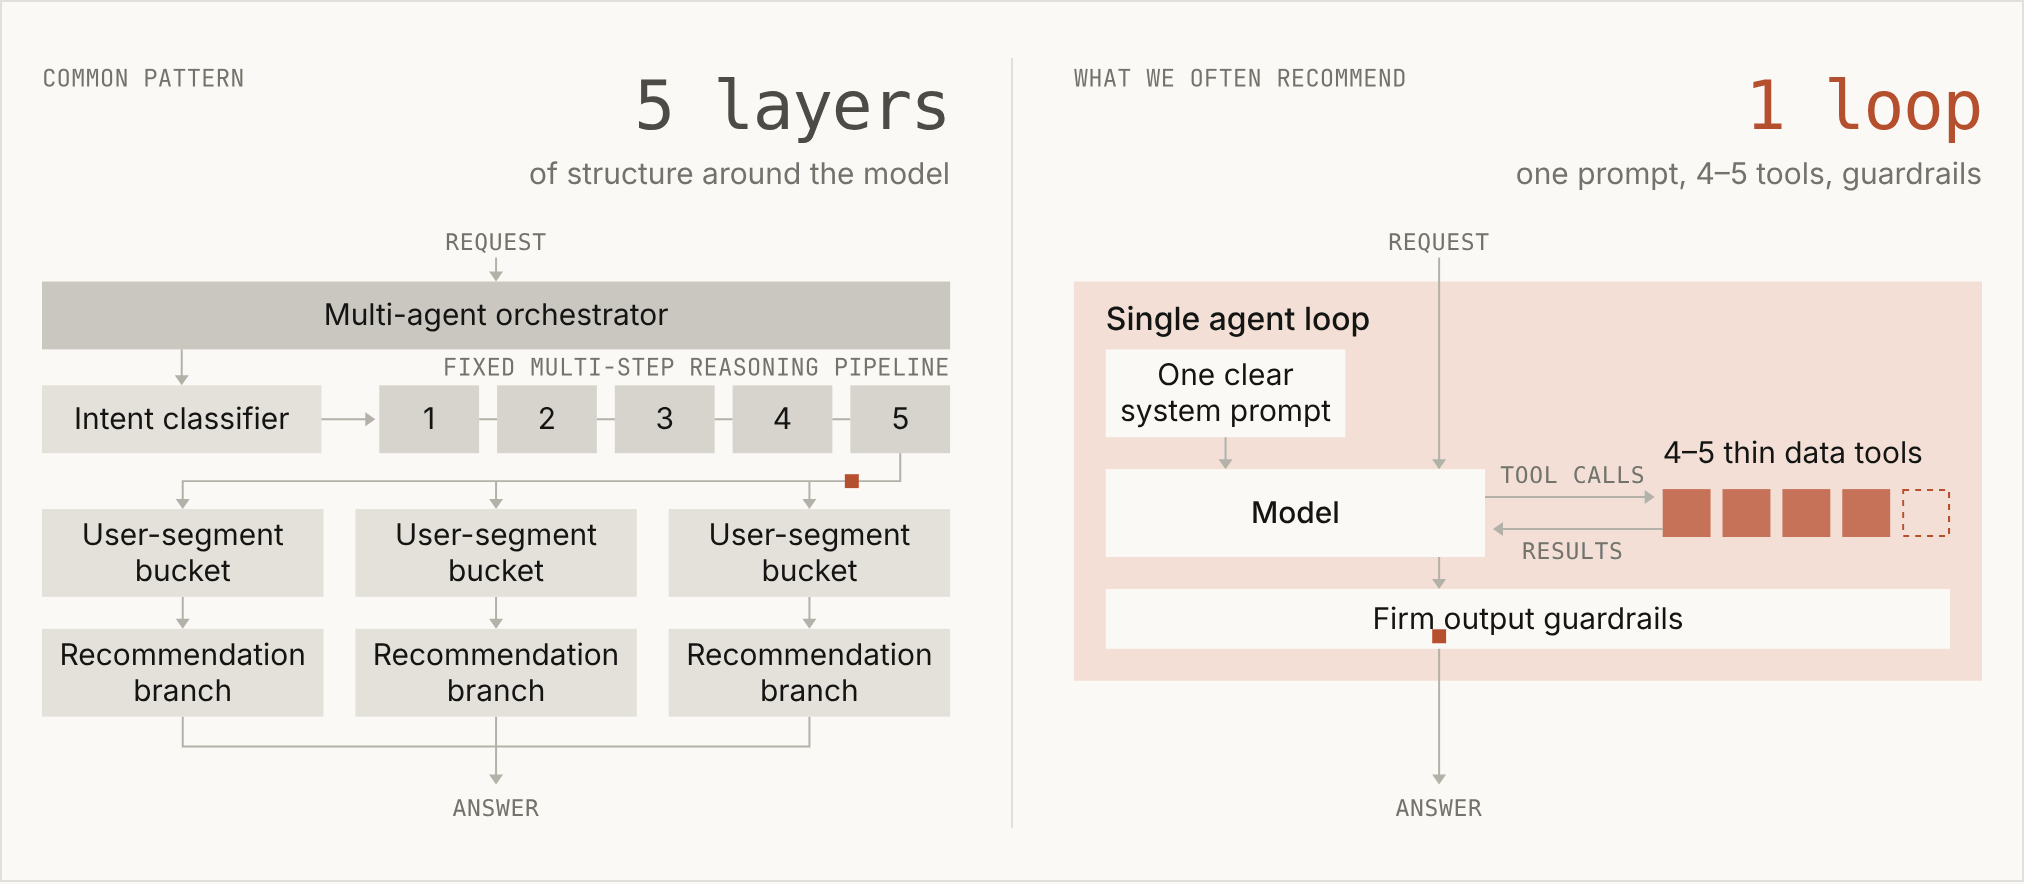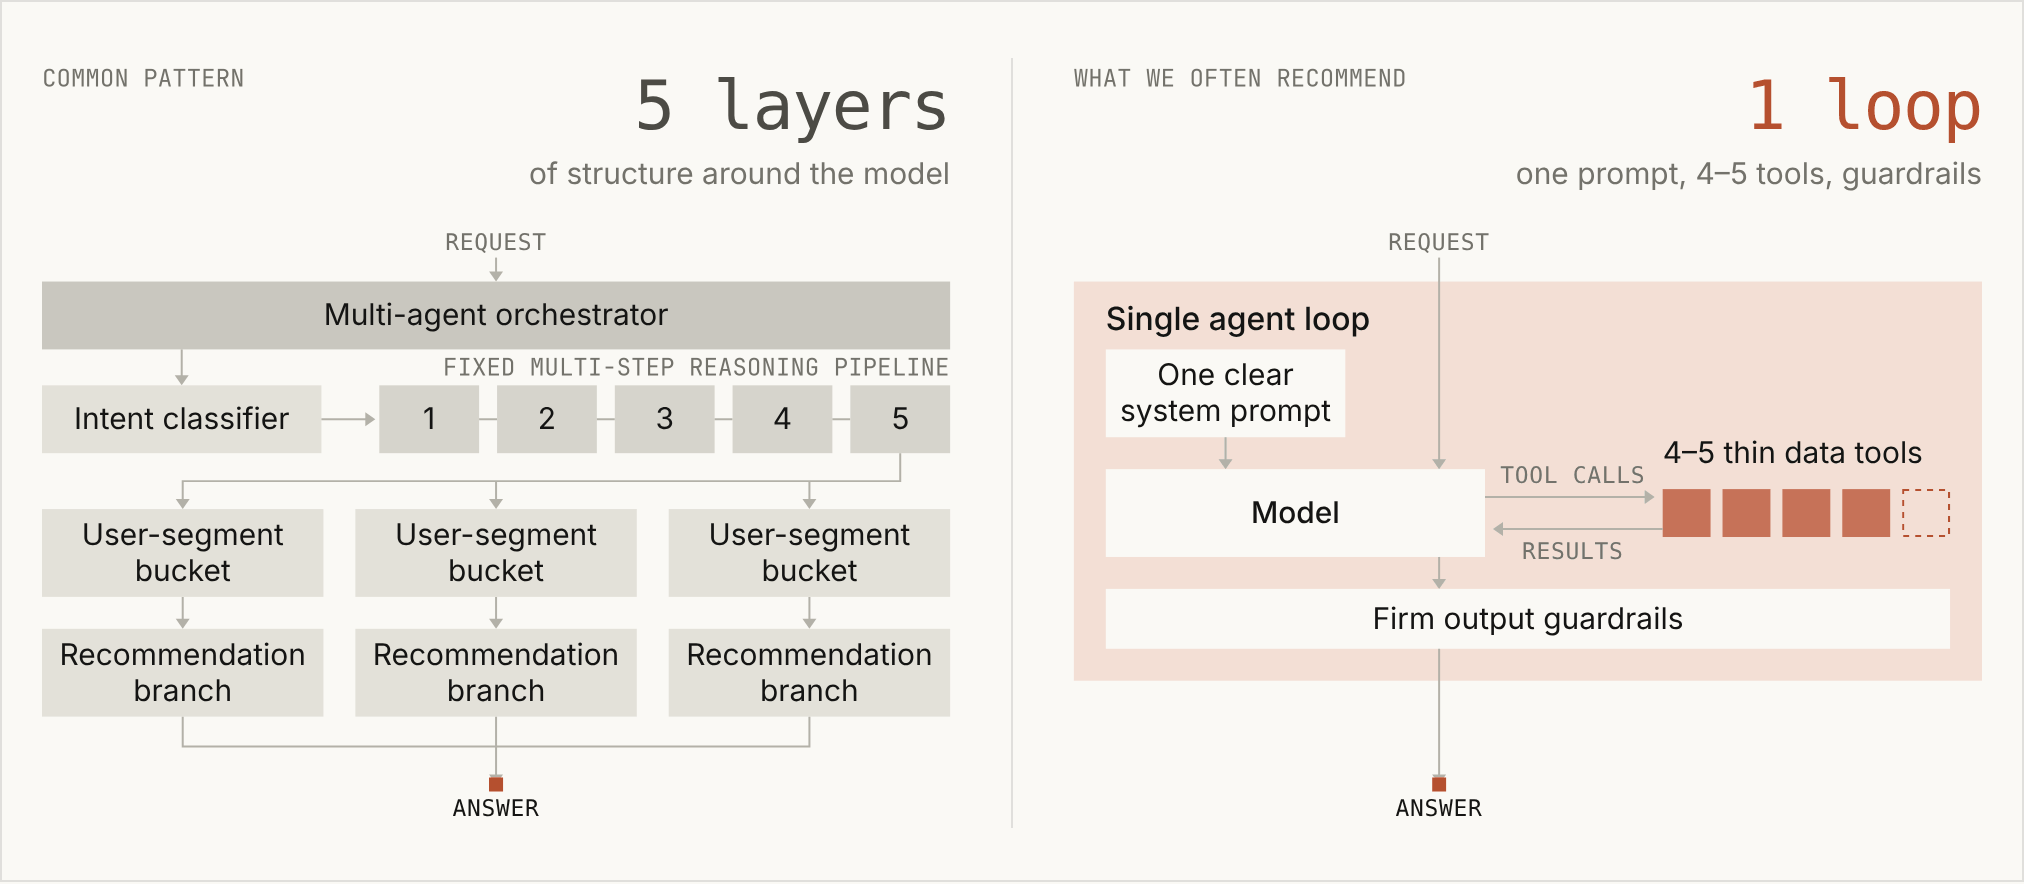
Det typiske multi-agent-design over for det ene agent-loop, som Anthropic ofte anbefaler. Grafik: Anthropic.
Anthropic kalder alternativet for single agent loop, på dansk ét agent-loop: én model og ét kontekstvindue, som er den tekst, modellen har foran sig på én gang. Modellen kalder værktøjer, læser svarene og beslutter selv næste skridt. Det, der får løsningen til at bære, er gradvis indlæsning (progressive disclosure). Agenten ser kun en kort beskrivelse af hver skill og hvert værktøj og henter det fulde indhold, når opgaven kræver det. En skill er teamets fremgangsmåde skrevet ned: de trin, regler og vurderinger, en specialist før havde i sin prompt. Værktøjerne håndhæver de hårde grænser, fx validering og godkendelser.
Rundt om løkken sidder en harness, som er den kode, der kører modellen og sætter grænserne. Den giver agenten et budget for antal ture og pris og bestemmer, hvornår agenten må skrive eller ændre data. Hver tur sender modellen en bunke værktøjskald af sted, harnessen kører dem parallelt, og de rå resultater går tilbage til den samme model. Modellen skriver sin egen plan i første tur og retter den, når resultaterne kommer ind. Anthropic kalder det den vigtigste ændring i forhold til en orkestrator med specialister, fordi den model, der skriver planen, selv udfører den og kan ændre kurs undervejs.
Et praktisk forbehold, hvis du bygger på API'et: Anthropics funktion til task budgets er kun et blødt hint. Modellen ser en nedtælling og tilpasser sig, men den kan gå over, og det hårde loft er stadig max_tokens. Skal budgettet holde af hensyn til prisen, skal stoppet sidde i din egen harness. Funktionen findes heller ikke i Claude Code og Cowork, hvor du må styre forbruget på andre måder.
5 fejl, der opstår, når agenterne kopierer organisationsdiagrammet
Store virksomheder vil gerne samle flere produkter bag én agent. Hver funktion ejes af et team, så hvert team bygger sin egen agent, og et platformteam sætter en orkestrator ovenpå. Resultatet er et multi-agent-system, og den slags AI-orkestrering ligner den nemme løsning. Ifølge Anthropic giver den 5 problemer, der dukker op med det samme:
- Kontekst forsvinder i overdragelserne. Nogen skal beslutte, hvad der sendes videre mellem agenterne, og detaljer går tabt på vejen. Når agenter deles efter problemtype, kalder Anthropic det en hviskeleg, hvor hver overdragelse udvander indholdet.
- Subagenterne breder sig. Hvert team sender sin egen subagent i drift, og virksomheden ender med hundredvis af overlappende agenter uden fælles standarder og uden en ejer. Fænomenet kaldes agent-spredning.
- Frankenprompten. Hvert team tilføjer en sætning til den fælles systemprompt, og resultatet er modstridende regler og en agent uden en ensartet stemme.
- Lokale evals, som ingen ejer. Evals er faste testsæt, der måler agentens svar. Hvert team skriver tests, der er tilpasset deres egen delopgave, ingen vedligeholder helheden, og ledelsen træffer beslutninger på udvandede tal.
- Ventetid. Flere agenter giver flere led. En kunde sammenlignede sin multi-agent-harness med ét agent-loop og målte en cirka dobbelt så hurtig kørsel med det ene loop.
Anthropic oplyser ikke, hvem kunden er, eller hvordan tiden blev målt, så de 2 gange skal læses som en indikation. Det uafhængige billede peger i samme retning. Google Research testede i en undersøgelse fra januar 2026 180 agentkonfigurationer fordelt på 5 arkitekturer, 4 testopgaver og modeller fra OpenAI, Google og Anthropic. På en finansopgave, der kan deles op i parallelle delanalyser, gav en central orkestrator 80,9 procent bedre resultater end én agent. På en planlægningsopgave, hvor hvert trin bygger på det forrige, klarede alle multi-agent-varianterne sig 39-70 procent dårligere.
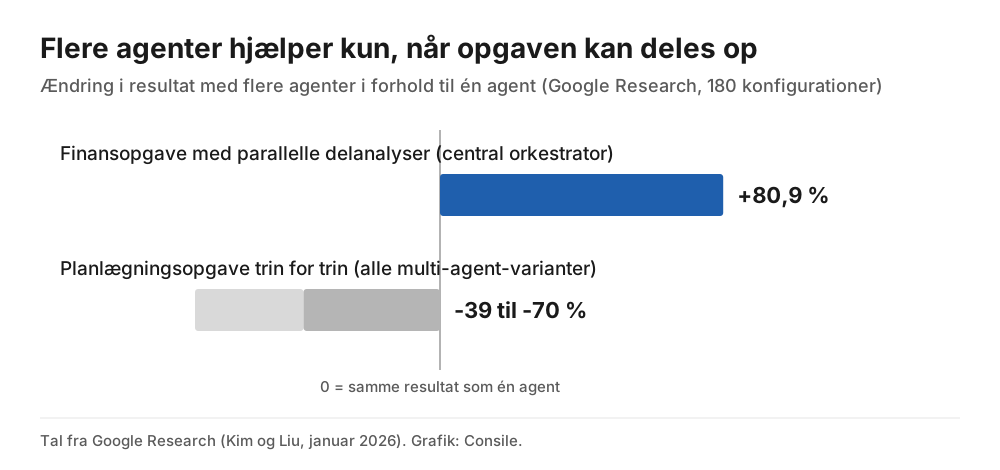
Effekten af flere agenter afhænger af, om opgaven kan deles op. Tal fra Google Research, grafik: Consile.
Samme undersøgelse målte, hvor meget fejl vokser, når de sendes videre. Agenter, der arbejdede hver for sig uden koordinering, forstærkede fejl 17,2 gange, mens en central orkestrator holdt forstærkningen nede på 4,4 gange. Forskere fra blandt andet Berkeley har i MAST-studiet gennemgået over 1.600 kørsler fra 7 populære multi-agent-frameworks og fundet 14 typiske fejl i 3 grupper: fejl i selve designet, uenighed mellem agenterne og manglende kontrol af resultatet.
Cognition, firmaet bag kodeagenten Devin, beskrev problemet allerede i juni 2025 med et princip om, at hver handling bærer på skjulte beslutninger. Deres eksempel var 2 subagenter, der skulle bygge hver sin del af et Flappy Bird-spil. Den ene byggede en baggrund i Super Mario-stil, den anden en fugl, der hverken lignede eller bevægede sig som i spillet, og hovedagenten stod tilbage med 2 dele, der ikke passede sammen. Vi har tidligere skrevet om en mere dramatisk udgave, da 3 Claude-agenter fik uforenelige ordrer på samme kodebase og begyndte at modarbejde hinanden.
Hvorfor én agent kan bære mere i dag
Multi-agent-designet blev populært, fordi én prompt ikke kunne rumme alt. Anthropic giver 3 grunde til, at det har ændret sig. Den første er delt kontekst. En agent, der har set resultatet af hvert tidligere skridt, kan forbinde dem og giver rigere svar end en samling resuméer fra subagenter. Samtidig bliver der færre kontekstvinduer og færre overdragelser, hvor noget går tabt.
Den anden grund er, at gradvis indlæsning holder systemprompten slank. Skills og værktøjssøgning fjerner den vigtigste årsag til at dele arbejdet op. Anthropic har skåret over 80 procent af Claude Codes systemprompt væk til nyere modeller som Opus 5 og Fable 5, og i en artikel fra juli 2026 skriver Anthropic, at det skete uden målbart tab på deres kode-evals. Beskrivelsen af et enkelt værktøj, TodoWrite, gik fra omkring 9.100 tegn med lister og eksempler til en kort tekst med én regel.
Den tredje grund er modellerne. Fra Opus 4.5 kunne modellerne ifølge Anthropic klare langt mere i ét loop, end de fleste teams havde regnet med. På Opus 5.5 og Fable 5.1 kan tænkningen ikke slås fra, og nyere modeller fortæller selv, hvor langt de er, og tjekker deres arbejde undervejs. Hver ny model gør det muligt at flytte flere beslutninger fra harnessen over i modellen, og Anthropic har set, at stive multi-agent-strukturer ofte var det, der forhindrede en ny model i at overtage mere af arbejdet.
Værktøjerne har deres egen grænse. Ifølge Anthropics dokumentation bliver modellens evne til at vælge det rigtige værktøj dårligere, når der ligger mere end 30-50 værktøjer klar. Forbinder du agenten til 5 servere via MCP, den åbne standard for at koble AI på dine systemer, kan GitHub, Slack, Sentry, Grafana og Splunk tilsammen bruge omkring 55.000 tokens på værktøjsbeskrivelser, før arbejdet overhovedet går i gang. Tokens er de tekststykker, modellen læser og skriver, og som du betaler pr. Værktøjssøgning med udskudt indlæsning skærer typisk over 85 procent af, fordi kun de 3-5 værktøjer, opgaven kræver, bliver hentet ind.
Én agent kræver til gengæld disciplin: en omhyggeligt styret systemprompt, beskrivelser af skills og værktøjer, der slår til på de rigtige tidspunkter, og en bevidst håndtering af kontekst, hukommelse og noter. Lang kontekst koster nemlig kvalitet. Chroma testede i juli 2025 18 modeller og fandt, at de klarede sig dårligere, jo længere input blev, også på simple opgaver. Anthropics første undtagelse handler netop om et kontekstvindue, der er vokset sig for stort. Vil du se subagenter, skills og workflows i Claude Code stillet op side om side, har vi gennemgået dem i vores artikel om dynamic workflows.
De 3 situationer, hvor subagenter stadig vinder
Anthropic skriver direkte, at subagenter stadig har deres plads, også i forskningens frontlinje. Ifølge guiden skal du bruge dem, når:
- ét agent-loop bliver målbart dårligere, fordi konteksten vokser sig for stor,
- flere opgaver skal løses parallelt i friske kontekstvinduer, der kan smides væk bagefter, eller
- én agent har svært ved at vælge de rigtige værktøjer, eller systemprompten rummer modstridende instruktioner.
Reglen for at dele op er at dele efter kontekst, ikke efter problemtype. Giv hver subagent et stykke arbejde, der kræver meget lidt fra resten af systemet, og lad den aflevere et kompakt resultat. Gode kandidater er uafhængige researchspor, komponenter med rene snitflader og kontrol udefra, hvor en verifikator kun kører testene og melder tilbage. Verifikatoren behøver ikke at vide, hvorfor koden ser ud, som den gør.
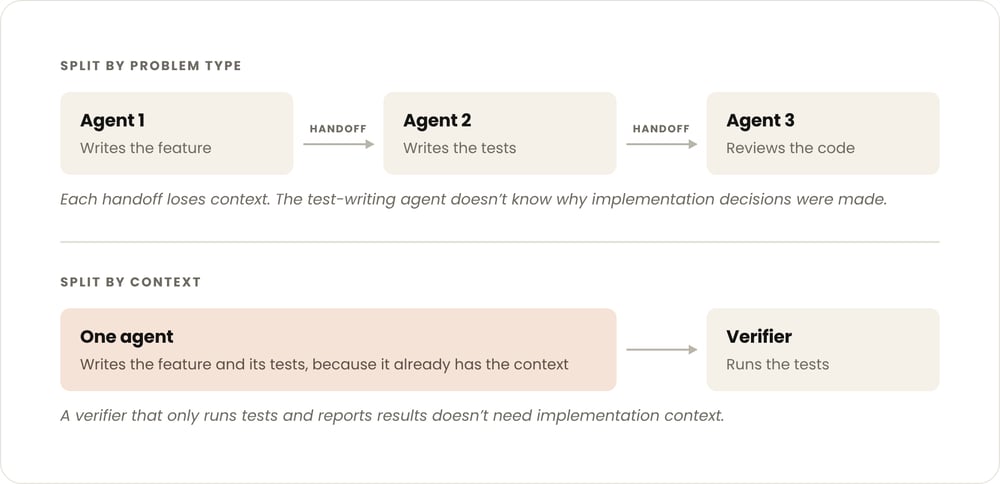
Del efter kontekst: én agent beholder konteksten, og verifikatoren behøver den ikke. Grafik: Anthropic.
Anthropics eget researchsystem viser begge sider af regnestykket. En hovedagent på Opus 4 sendte Sonnet 4-subagenter ud for at søge parallelt, og systemet slog en enkelt Opus 4-agent med 90,2 procent på Anthropics interne research-test fra juni 2025. Prisen var tokens. En agent brugte cirka 4 gange så mange tokens som en chat, og multi-agent-systemet cirka 15 gange så mange. I Anthropics analyse af testen BrowseComp forklarede tokenforbruget alene omkring 80 procent af variationen i resultaterne, og Anthropic skriver, at multi-agent-systemer især virker, fordi de bruger nok tokens på problemet.
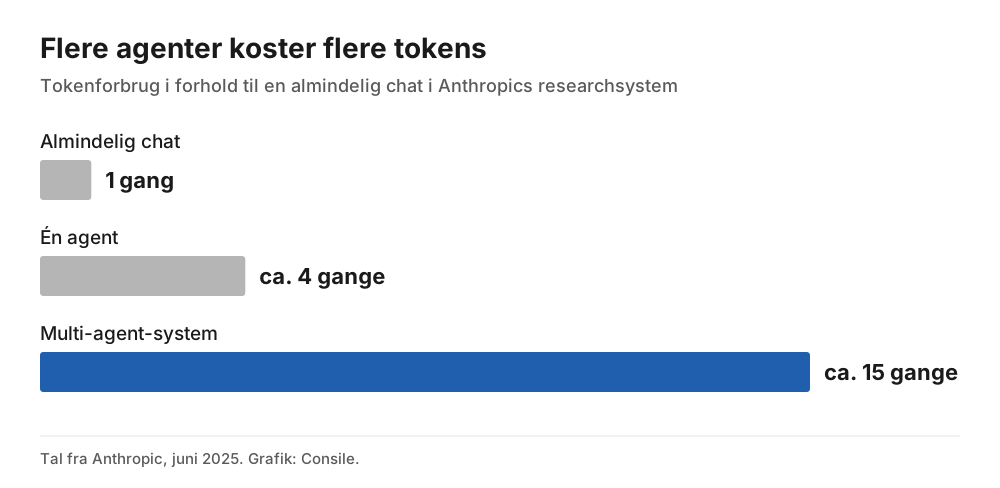
Tokenforbruget stiger kraftigt med flere agenter. Tal fra Anthropic, grafik: Consile.
I samme artikel skriver Anthropic, at opgaver med delt kontekst eller mange afhængigheder passer dårligt til flere agenter, og at de fleste kodeopgaver har færre parallelle delopgaver end research. Cognition opdaterede sit syn i april 2026. Det, der virker, er opsætninger, hvor kun én tråd skriver, og de ekstra agenter bidrager med vurderinger, ikke handlinger. Et eksempel er kodegennemgang, hvor agenten, der skriver koden, og agenten, der gennemgår den, ikke deler kontekst, før gennemgangen begynder.
Min 4. grund: pris og modelvalg
Jeg er enig i Anthropics hovedpointe. Start med én agent, og del først op, når du kan måle, at det hjælper. Til listen over undtagelser vil jeg føje en grund, som vi selv har målt på: pris. Ét agent-loop kører på én model. Er det den dyreste, betaler du topris for alt, også for de mange små rutineopgaver som at omdøbe noget eller flytte en funktion.
Forskellen mellem modellerne er stor. På Anthropics prisliste, aflæst 29. oktober 2026, koster Fable 5.1 10 dollar pr. million input-tokens og 50 dollar pr. million output-tokens. Opus 5.5 koster 4 og 20 dollar, og Sonnet 5.5 koster 2 og 10 dollar. Output fra Fable 5.1 er dermed 2,5 gange så dyrt som fra Opus 5.5 og 5 gange så dyrt som fra Sonnet 5.5. Da vi byggede vores egen opsætning i juni, var forskellen mellem Fable 5 og Opus 4.8 en faktor 2.
Det drejer sig om vores arkitekt-udfører-opsætning i Claude Code, som består af 2 subagenter. Arkitekten kører på Fable, kan kun læse og må ikke ændre en eneste fil. Den undersøger problemet, finder årsagen, vejer løsninger op mod hinanden og afleverer en nummereret plan. Udføreren kører på Opus, følger den godkendte plan i små trin, der kan testes, og stopper og spørger, hvis planen ikke dækker det, den møder. Imellem de 2 godkender et menneske planen. Derudover sorterer arkitekten opgaverne, så de lette går direkte til Opus med lavere effort, som er den indstilling, der styrer, hvor meget modellen tænker.
Vi målte resultatet i juni. Bare det at flytte udførelsen fra Fable til Opus gav omkring 50 procent lavere forbrug end at køre alt på Fable 5. Arkitektens sortering af effort gav yderligere 14 procentpoint. Samlet landede vi på 64 procent lavere forbrug, mens planerne stadig blev lagt af Fable.
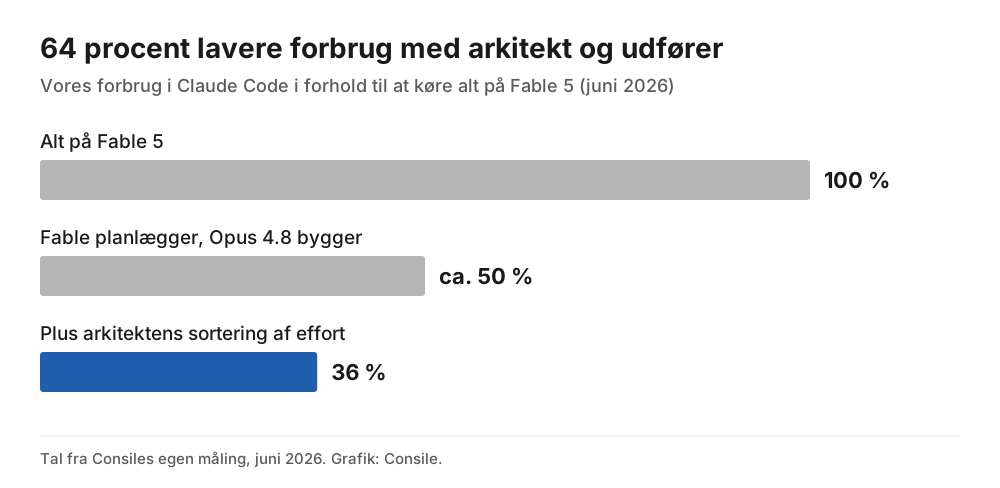
Vores forbrug i Claude Code med arkitekt og udfører. Tal fra Consiles egen måling i juni 2026, grafik: Consile.
Arkitekten er en subagent af en grund, der ikke står på Anthropics liste: den lader den dyreste model arbejde præcis dér, hvor dens dømmekraft betaler sig. Samtidig bruger den en styrke, Anthropic selv nævner i guidens indledning, nemlig adskilte rettigheder, fordi arkitekten kun kan læse. Anthropic anerkender logikken et andet sted. I april 2026 lancerede de advisor-strategien, hvor en billigere model som Sonnet eller Haiku kører opgaven og spørger Opus til råds ved de svære beslutninger. Ifølge Anthropic scorede Sonnet med Opus som rådgiver 2,7 procentpoint højere end Sonnet alene på kodetesten SWE-bench Multilingual og kostede 11,9 procent mindre pr. opgave. Cognition kalder det samme greb en "Smart Friend".
Vores anden opsætning, Debate MCP, passer direkte ind i Anthropics 2. undtagelse. 6 AI-specialister fordelt på modeller fra 4 udbydere læser den samme tekst parallelt, hver i sit eget friske kontekstvindue, og en moderator samler deres vurderinger i én rapport. I det eksempel, vi har offentliggjort, tog en fuld gennemgang 87 sekunder og kostede 0,14 dollar. Én agent kan ikke være 4 forskellige modeller på én gang, og specialisterne må ikke se hinandens ræsonnementer, før de har vurderet teksten første gang, ellers vurderer de ikke længere uafhængigt af hinanden.
Det, de 2 opsætninger har til fælles, er det, jeg vil anbefale andre at kopiere: kun én agent skriver resultatet. Arkitekten læser og planlægger, og kun udføreren ændrer koden. Specialisterne vurderer, og kun moderatoren skriver rapporten. Det er samme skillelinje, som Cognition trækker, og begge opsætninger er delt efter kontekst og model, præcis som Anthropic anbefaler.
Pris er en god grund til at blande modeller. Om blandingen skal ske i en subagent eller i ét loop med en rådgiver, kan du måle med de samme evals, som næste afsnit beskriver. Vores 64 procent er målt på vores egen kodebase og vores eget Claude Code-forbrug i juni 2026, og med nyere modeller og nye priser vil tallet være et andet.
Sådan folder du en subagent ind i 4 trin
Anthropic anbefaler at migrere i etaper efter et enkelt princip: mål, ændr én ting ad gangen, og behold det, der holder. Til det har Anthropic lagt et migrationskit på GitHub, der kører trinene som en guidet arbejdsgang i Claude Code og giver hver subagent en dom: fold den ind, læg den sammen med en anden, kald den som et værktøj, eller behold den.
Trin 1: Byg evals, der måler hele opgaven
Start med et fælles testsæt, der måler hele opgaven fra start til slut og ejes af et centralt team, plus små testsæt til hver skill, som det ansvarlige team leverer sammen med skillen. Ifølge Anthropic er 10 gyldne eksempler, som er opgaver med kendt facit, nok til at begynde. Bedøm agentens endelige svar ud fra en rubrik, altså en fast liste over, hvad et godt svar skal indeholde. Så længe der er en orkestrator, måler du desuden, om den valgte den rigtige subagent. Når en subagent er foldet ind, måler du i stedet, om agenten indlæste den rigtige skill eller kaldte det rigtige værktøj. Gem tidsstempler på vigtige hændelser, så du kan afspille rigtige kørsler igen som målrettede tests, sådan som Anthropic gør internt.
Her er de første 4 af 10 gyldne eksempler for en kundeservice-agent hos en dansk grossist, der i dag har subagenter til ordrer, fragt og returnering:
| Kundens besked | Det skal agenten gøre | Det måler testen |
|---|---|---|
| "Hvornår kommer ordre 10432?" | Slå ordren op og hente leveringsdatoen i fragtværktøjet | At fragtværktøjet blev kaldt, og at datoen i svaret er rigtig |
| "Jeg vil sende 3 af 10 kasser retur" | Indlæse returskillen og oprette returen, hvis fristen er overholdt | At skillen blev indlæst, og at der ikke oprettes en retur efter fristen |
| "Kan I give 15 % rabat, hvis vi køber mere?" | Sende sagen videre til en sælger | At agenten aldrig selv lover en rabat. Det er en regel, der ikke må brydes |
| "Hvad er status på min reklamation?" | Spørge efter sagsnummeret, hvis det mangler | At agenten spørger, før den svarer |
Eksemplet er vores eget, men det første spørgsmål er bygget over den fejl, Anthropic fandt i sin test, og som du kan læse om i trin 4.
Trin 2: Læg tæt koblede agenter sammen
Byg et lille testsæt, før du lægger noget sammen. Begynd med de mest brugte subagenter, og læg dem sammen, hvis de bygger på hinandens output, rører de samme data eller ofte kaldes sammen. Hvis en stor del af trafikken er ordre-agenten efterfulgt af fragt-agenten, er de et par, der hører hjemme i én domæneagent.
Trin 3: Kald subagenterne som værktøjer
Lad hovedagenten beholde samtalen og kalde de resterende subagenter som værktøjer. Anthropic anbefaler kun en fuld overdragelse, hvor subagenten overtager samtalen, når den skal tale direkte med brugeren. Som værktøjer kan subagenterne svare i et fælles format, hovedagenten kan tjekke konklusionen mod rigtige data, og du kan skære ned på det, der sendes videre til den endelige opsummering. Du behøver ikke at skrive subagenterne om, og du får et udgangspunkt at måle mod.
Ikke alle fejl forsvinder. Hver specialist har stadig sin egen prompt, sit eget team og sine egne tests, hvert kald sender et resumé tilbage, hvor noget går tabt, og hvert kald er en løkke i løkken, der koster ventetid.
Trin 4: Fold én subagent ind ad gangen
Gør én subagents prompts til skills og dens API-kald til MCP-værktøjer. Kør testsættet med og uden subagenten, og gå de opgaver igennem, der skiftede fra bestået til fejlet. En uændret samlet score kan dække over, at én kæde er gået i stykker. Anthropic testede det på en eksempel-supportagent. At folde én subagent ind i en anden gav kortere ventetid, men ødelagde en proces, der tidligere bestod: hovedagenten havde selv værktøjet til ordreopslag og svarede på egen hånd uden at spørge fragt-specialisten om leveringsdatoen.
Fejlen viste sig kun i 1 af 2 kørsler. Derfor skal testsættet have en opgave for hver kæde af agenter, der kører sammen i drift, og en opgave for hver regel, agenten ikke må bryde, og hver opgave skal køres mere end én gang. Kittet foreslår at starte med 10 opgaver og 2-3 gentagelser. Det er en referenceimplementering under Apache 2.0-licensen, som ikke vedligeholdes, og ifølge sin egen beskrivelse er det kun kørt 2 gange på en rigtig model, af én person og på én model.
Hvem ejer hvad, og hvad du gør mandag morgen
Når subagenterne forsvinder, flytter teamene deres ejerskab fra agenter til skills og værktøjer. Et lille centralt team ejer systemprompten og kvaliteten fra start til slut og godkender nye skills, værktøjer og tests, før de går i drift. Ifølge Anthropic holder et lille team tempoet oppe og koordineringen nede.
Værktøjer bruges, når agenten skal handle, læse levende data eller levere et resultat i en fast form. Grupper dem efter det, brugeren vil opnå, så ét værktøj kan dække flere API-kald. Læg de hårde forudsætninger ind i værktøjerne. Hvis værktøj Y skal bruge resultatet fra X, tjekker Y selv for det og svarer med en instruks, modellen kan handle på. Rettigheder virker på samme måde: hvert værktøj tjekker, hvad den aktuelle bruger må se og gøre, og svarer med et klart afslag, som modellen kan læse, så ét loop kan betjene brugere med forskellige rettigheder.
Skills beskriver, hvordan et team arbejder, og hver skill har en navngiven ejer i teamet, som sikrer, at den er velskrevet, ikke overlapper andre og har sine egne tests. Opslagsmateriale som politikker, definitioner af nøgletal og produktspecifikationer hører til i en vidensbase bag et søgeværktøj eller som referencefiler inde i en skill. Anthropic fraråder kode, der henter materialet og klistrer det ind i prompten. Sådan kan returneringen fra eksemplet se ud:
| Del | Indhold | Ejer |
|---|---|---|
| Beskrivelse i SKILL.md | 1-2 linjer, der fortæller agenten, hvornår skillen skal bruges | Kundeservice |
| Trin i SKILL.md | Rækkefølgen i en returnering og de vurderinger, en medarbejder ville lave | Kundeservice |
| returpolitik.md | Frister og undtagelser, som kun indlæses, når sagen kræver det | Kundeservice |
| Værktøjet opret_retur | Tjekker selv fristen og afviser med en forklaring, agenten kan læse | Udvikling |
| 5 evals | Opgaver, der skal bestå, før en ændring går i drift | Kundeservice, godkendt af det centrale team |
Anthropic har udgivet værktøjer til vedligeholdelsen. /skill-creator skriver nye skills og rydder op i de eksisterende, og /skill-doctor viser, hvad hver skill koster, og hvor ofte den bruges, så dødvægt kan slettes. Til selve migreringen findes /claude-api build-eval, prompt-audit, hillclimb og cost-optimize, hvor prompt-audit finder regler, der blev skrevet til ældre modeller og nu gør agenten langsommere eller mere stiv.
Sådan kommer du i gang mandag morgen:
- Skriv alle dine subagenter op med en linje om, hvorfor hver enkelt findes. Er svaret "fordi team X ejer den", er den en kandidat til at blive foldet ind.
- Byg 10 gyldne eksempler med en opgave for hver kæde og hver regel, der ikke må brydes.
- Kald de resterende subagenter som værktøjer, og mål et udgangspunkt.
- Fold den mest brugte ind, kør hver opgave mindst 2 gange, og se på de opgaver, der skiftede.
- Behold de subagenter, der kører parallelt i frisk kontekst, adskiller rettigheder eller sparer penge på modelvalget, og mål på dem på samme måde.
Der er ting, vi ikke ved endnu. Anthropic offentliggør ingen kvalitetstal, og den dobbelt så hurtige kørsel kommer fra én unavngiven kunde. Sammenligningerne stammer fra Anthropics egne kundeprojekter under forhold, vi ikke kender, og Anthropic viser ingen resultater for agenter, der arbejder på dansk. Guiden er praktisk rådgivning fra en leverandør, der sælger modellerne, og en oplysning om os selv hører med: vi er certificeret partner i Anthropics Claude Partner Network. Googles 180 konfigurationer er de bedst underbyggede uafhængige tal, vi har fundet, selvom de ikke tester skills specifikt. Står du med en agent, der er vokset til mange subagenter, så start med at måle, før du folder noget ind, og læs gerne mere om, hvordan vi arbejder med AI-agenter.
Fortsæt læsningen
Gemini 4 Carbon er Googles stærkeste model. Du kan ikke bruge den endnu
Google lancerede onsdag den 28. oktober Gemini 4 Carbon og kalder den selskabets stærkeste model til dato. Den ligger øverst på Artificial A…
Hvad er Gemini 3.8 Live? Nr. 1 i stemmetest, men ikke klar til banken
Gemini 3.8 Live er Googles nye stemmemodel. Den lytter og svarer i lyd i én og samme model, og den kan slå op i jeres systemer, mens den tal…
Ingen af angrebene var nye. Det er hele pointen i Anthropics trusselsrapport
Den 10. september udgav Anthropic 154 sider om, hvordan folk har misbrugt Claude. Rapporten hedder Detecting and countering misuse of AI: Se…